继续前几篇的假设场景。你已经不让助手直接修改会议清单,而是说:“先把方案发给我看看,最好带一小段配置示例。”
这一次,注意力从文件转到了聊天窗口。
有时,屏幕上先出现半句话,随后这条消息不断变长,像有人在里面继续打字。有时,助手却连着发来几个气泡:一段解释、一段代码,最后再补一句提醒。明明都是同一个问题,为什么回复的长相不一样?
最容易想到的解释是模型输出方式变了。但从模型产生文字,到你在渠道里看到消息,中间还有一段专门处理“怎么说出来”的程序。它要认出哪些是新增文本,哪些是完整快照;决定在哪里切开,又要不要把小块合起来;最后还得避免已经发过的内容在结束时再来一遍。
本文沿用 OpenClaw v2026.5.22,聚焦内置 Pi 订阅处理、通用块回复管线,并用该版本 Telegram 预览实现作具体例子。其他渠道和新版本可能有不同能力,不能据此推断所有聊天平台都走相同接口。流式输出说明
看起来都在“流”,其实不是同一种消息
先把屏幕上的两种现象分开。
一种是预览更新:先有一条可见消息,再反复修改它的内容。以本文的 Telegram 路径为例,初次创建使用 sendMessage,有了消息标识以后使用 editMessageText。用户看到文字不断长出来,底层却不一定为每一小段文字创建一个新气泡。Telegram 预览传输
另一种是正式分块投递:助手写出一部分内容后,OpenClaw 把它整理成块,作为普通渠道消息发出去。下一块可能成为另一条消息。这里的“流式”指逐步交付可读内容,不是让渠道原样接收模型的每一个 token。
这也意味着,名为 block 的设置不能脱离位置理解。在支持预览的渠道中,预览模式里的 block,与开启正式块回复,并不是同一个开关。文档对这种命名区别有专门解释;具体映射仍要结合渠道适配器,而不是只搜到一个字段就下结论。预览与块回复的区别
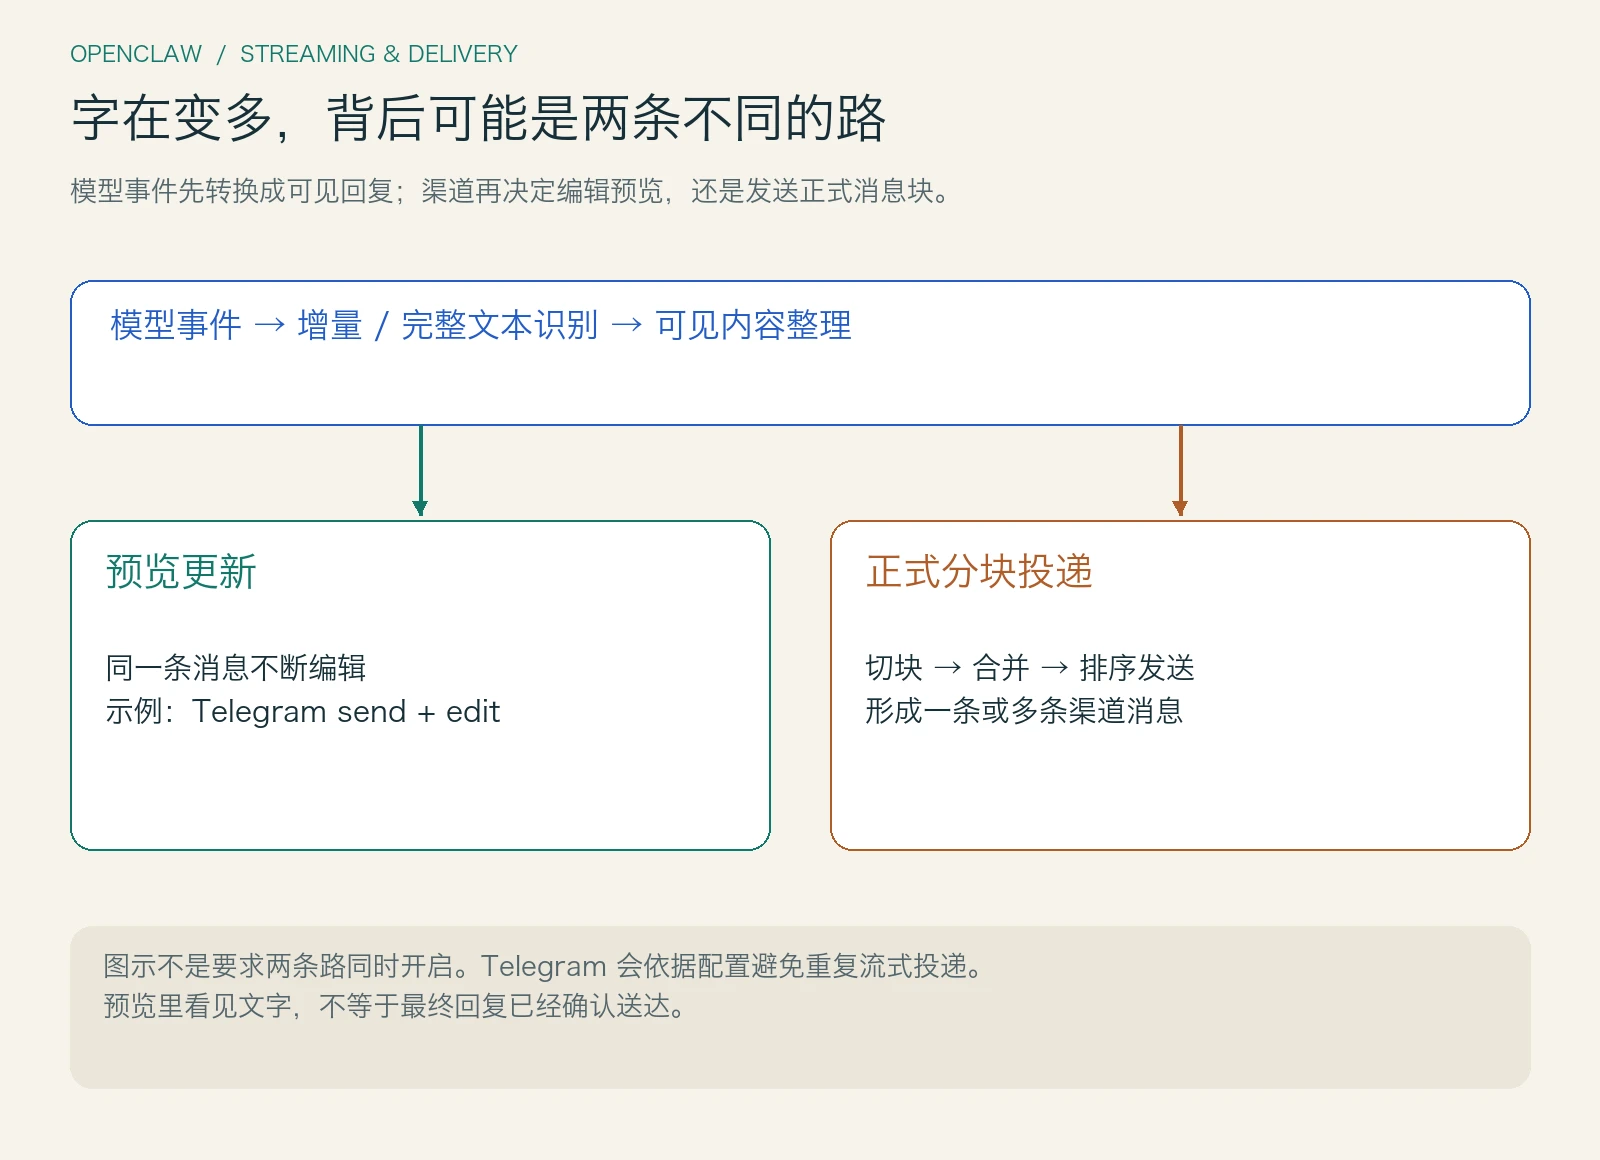
回到清单方案。如果你期待“先看到进展,最终留下一条完整回复”,预览更接近这个体验;如果希望长答案分段抵达,正式块回复更接近它。但两种路径都需要处理结束时的收尾,不能因为文字已经出现在屏幕上,就认定最终投递也成功了。
模型说“这里是全文”,不能再接到全文后面
流式处理中一个很小、却很实际的问题是:事件里的文字到底代表什么?
设想程序已经收到“第二项建议”,随后模型接口在 text_end 里又给出“第二项建议拆成两步”。如果程序不区分事件形态,直接把这一段继续接到后面,你就会看到重复开头。
订阅处理器里的 resolveAssistantTextChunk() 专门处理这类情况。普通 text_delta 使用增量;结束事件如果带完整内容,并且以已有文本开头,就只追加缺少的后缀。若内容与已有文本相同,或者只是已有内容的更短前缀,就不再追加。文本片段识别
我在局部实验里验证了这个例子:已有 hello,结束内容是 hello world,函数只返回 world;已有完整的 hello world,同样的结束内容返回空字符串。
但这个辅助函数不是一套万能的文本差异算法。供应方改变前面的文字时,不能只靠“多出来多少字符”处理所有情况。后续可见输出逻辑还会比较清理后的文本与上次输出:如果新文本不再以前一次为前缀,就标记 replace,相应路径也会重置块缓冲。可见文本更新
因此,排查重复或丢字时,先确认输入是增量、累计全文还是替换,比直接修改切块长度更有效。它们看起来都只是字符串,含义却不同。这个层级还处理可见内容、指令和推理相关边界,本文不把原始模型事件当成一定可以直接显示的文本。
代码块不能随便拦腰切,长答案也不能一直等
现在文字已经整理好,下一件事是决定什么时候发出一块。
如果每来几个字符就发送,方案还没说完,群里已经刷了十几条消息。反过来,如果一定等全文结束才发,长任务又会显得像没有响应。
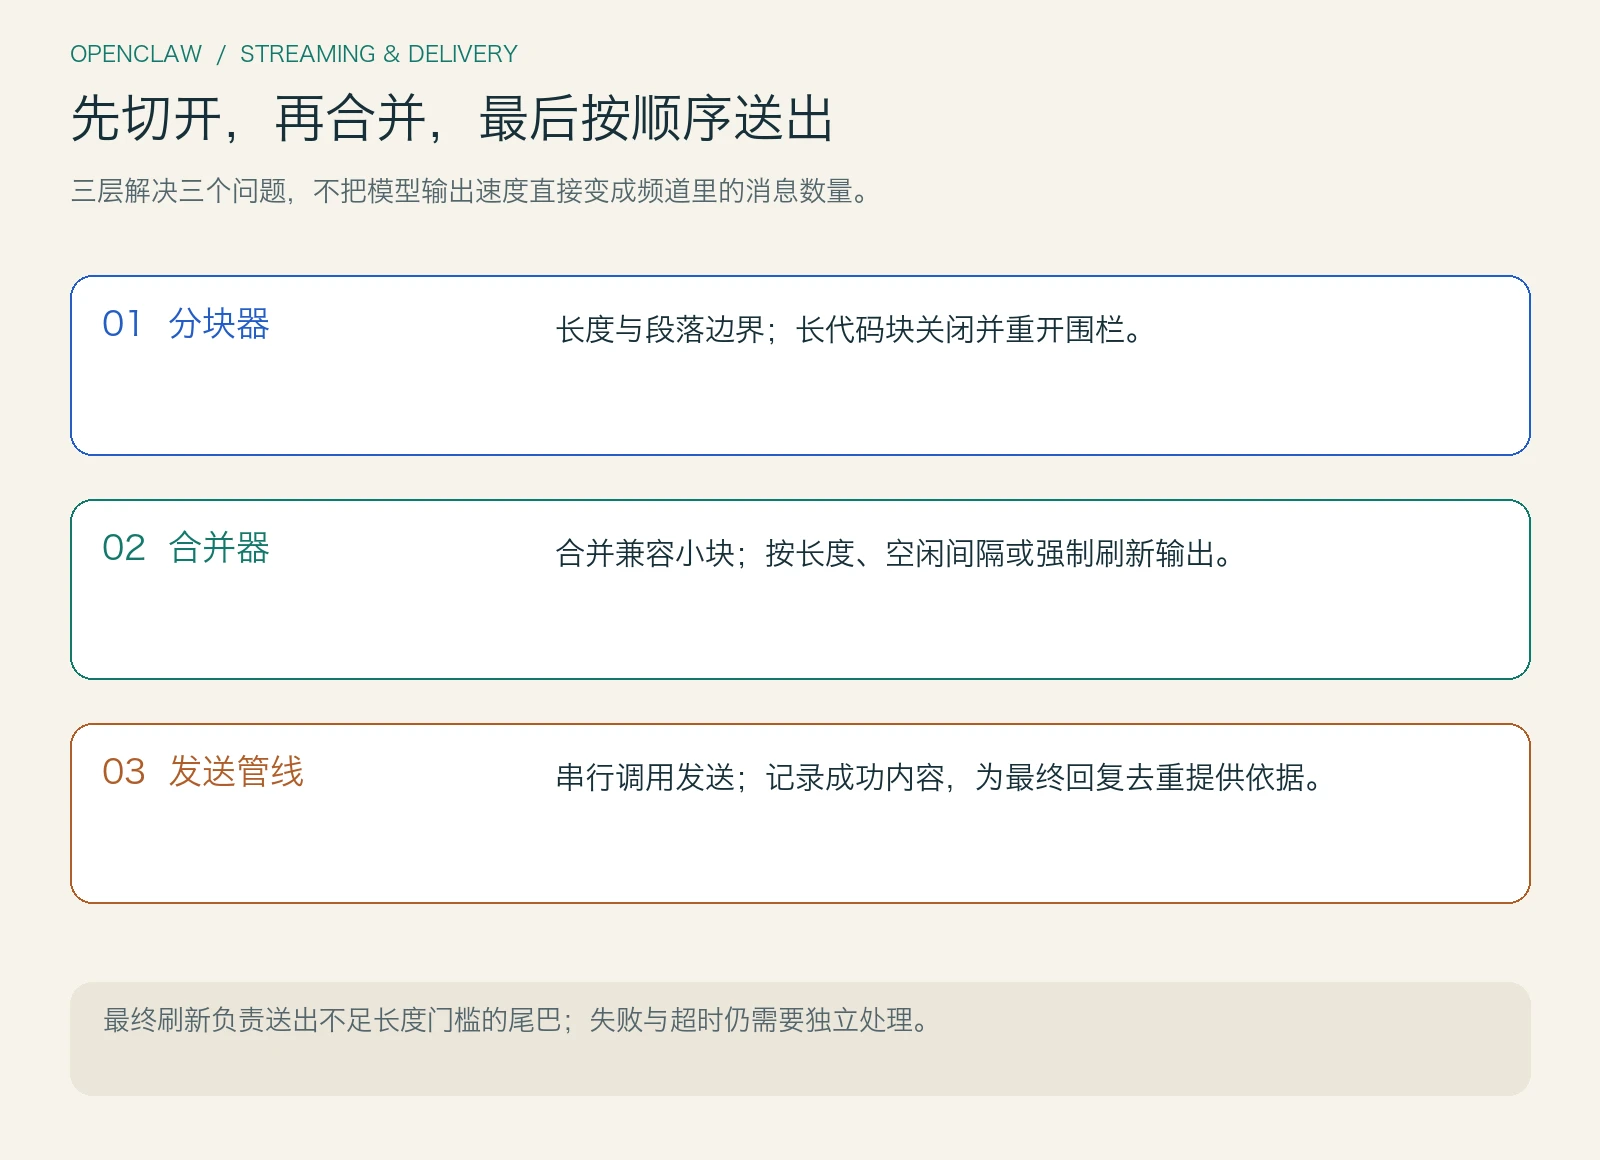
EmbeddedBlockChunker 使用最小长度、最大长度和断点偏好来折中。少量文字可以先留在缓冲区;达到条件后,尽量寻找段落、换行或其他可用断点;过长而没有合适位置时,仍需要切开。结束时的强制刷新负责把不足最小长度的尾巴送出去。分块器
这些阈值在这一层依据 JavaScript 字符串长度计算,不是模型 token 数,也不是网络字节数。更不能把“达到最小长度”理解成“必定立即发消息”:断点、刷新模式和下游合并层,都可能继续影响时机。
清单里的代码示例会带来另一个麻烦。如果直接在 Markdown 代码围栏中间断开,下一条消息可能从代码中部开始,却没有开头的围栏,渲染效果就变了。
分块器会识别围栏。需要在长代码块中切开时,它给当前块补上关闭围栏,再在后续块重新打开,并保留语言标记。围栏识别
我用一个刻意设得很小的长度上限,让十行配置风格的代码分成了三块。三个输出都保留了开闭围栏,但其中一个断点仍落在语句中间。这一点很值得记住:它在保护 Markdown 展示结构,不是在解析程序语法,更没有承诺每条气泡中的代码都可独立运行。读者如果只复制其中一块,仍可能拿到不完整片段。
已经切好了,为什么还要合并一次?
分块器关心哪里适合切。发送体验还有另一个问题:即使每一块都合法,连续十条很短的消息也未必舒服。
因此,通用管线里还有 BlockReplyCoalescer。它把兼容的小块放进一个文本缓冲区,根据长度、空闲间隔或强制刷新条件决定何时交给发送层。这里的空闲间隔,是等待新的块输入暂时停下来;不是判断模型已经完成整个任务。块合并器
两层处理并不矛盾。前一层让长输出能被合理拆开,后一层控制这些拆开的内容以什么节奏出现在渠道里。你看到的一条正式消息,可能包含不止一个上游块;反过来,渠道自己的长度和格式限制,还可能继续处理待发送内容。
当然,不是所有东西都应该糊成一段文字。合并器会关注回复目标、语音标记、推理或状态类消息的差异;媒体也有单独处理。管线还能利用助手消息序号,在跨越逻辑消息边界时刷新前面的缓冲。否则,“我正在检查”和“最终方案如下”可能被不恰当地合成一块。块回复管线
这一层也解释了为什么模型已经输出,渠道却还没马上出现新气泡:内容可能在等一个可读断点,也可能在等合并窗口。要知道到底等在哪里,得观察每层缓冲,而不是只看模型输出速度。
已经发过两段,结束时还要再发全文吗?
假设方案先发出第一段,再发出代码示例。运行结束以后,上层又拿到了完整回答。如果直接把完整回答再投递一次,你就会收到“逐段版”和“全文版”两套内容。
OpenClaw 的块回复管线维护了待发送和已发送的键。发送通过 Promise 链串起来,以保持调用顺序;发送回调成功之后,才登记成功内容和媒体地址。最终回复组装会参考这些记录,过滤已经交付的内容。发送记账、最终回复过滤
这里的重复也有不同层次。管线既有考虑回复目标的投递键,也有用于最终内容抑制的内容键;后者不包含 replyToId,避免同样内容仅因最终载荷的回复目标字段不同,就再次出现。对于已经逐块发出的纯文本,它还会比较合并片段与最终文本,比较时忽略空白差异。
这是一种具体的实现策略,不是跨平台、跨进程的“恰好一次”承诺。媒体、状态消息与普通文本有不同规则,新的有效内容也不能因为前面出现过预览,就被一概丢掉。尤其预览更新和正式块投递的去重对象不同,不能拿其中一层的集合解释所有重复消息问题。
Telegram 的适配代码还会根据预览和块回复配置选择路径,避免双重流式发送。收尾阶段究竟编辑已有预览,还是走普通最终投递,也属于渠道自己的职责。Telegram 分发入口
最后一段发不出去时,“完成”应该怎么说?
流式回复把成功拆成了几个阶段,也把失败拆开了。前面两段发出去了,最后一段却超时,不能简单说“这次没有回复”;但同样不能说“完整答案已经送达”。
通用块发送管线在超时后会触发取消信号,并标记这条管线中止,跳过剩余块以保护顺序。普通发送错误则被记录处理。didStream 与 isAborted 分别反映不同方面,调用者不能只看其中一个就推断整个答案完整交付。管线错误处理
取消信号也不是时光倒流。如果远端实际上已经接收,只是确认丢了,不能仅凭本地超时断言用户没看见。这与上一期“超时不等于旧工作消失”的边界相呼应。本文没有制造真实 Telegram 网络故障,因此不报告某种失败下必然发生重复或丢失。
本期运行了 24 项局部检查,直接导入原始分块器与围栏解析模块,并原样抽取文本片段识别函数。验证覆盖缓冲、最终刷新、段落切分、长文本、代码围栏和完整文本重复事件。合并器、发送管线与 Telegram 适配来自源码核对,没有运行真实渠道、模型或完整端到端流程。
如果让我自己实现,第一版就会分开记录“模型产生了什么”“准备显示什么”“哪些内容得到发送确认”。分块器、节奏控制与渠道发送分别提供接口,避免某个渠道的编辑规则渗进模型循环。诊断里则保留阶段和消息标识,让“看见一点文字”和“收到完整答案”有可追踪的区别。
回到那份带代码示例的清单。你看到的回复并非模型原文穿过网络就落在屏幕上,而是经过整理、缓冲、分块与投递后的结果。下一篇,我们再往另一边看:对话越聊越长,当历史装不进模型上下文时,OpenClaw 会留下哪些内容,又会把哪些压缩成摘要?