这是一个真正落地到医院康复科的边缘视觉项目。目标不是把摄像头画面“识别出来”就结束,而是把医生原本依赖经验完成的步态和平衡评估,拆成一条可以采集、计算、解释和复核的本地化流程。
业务流程
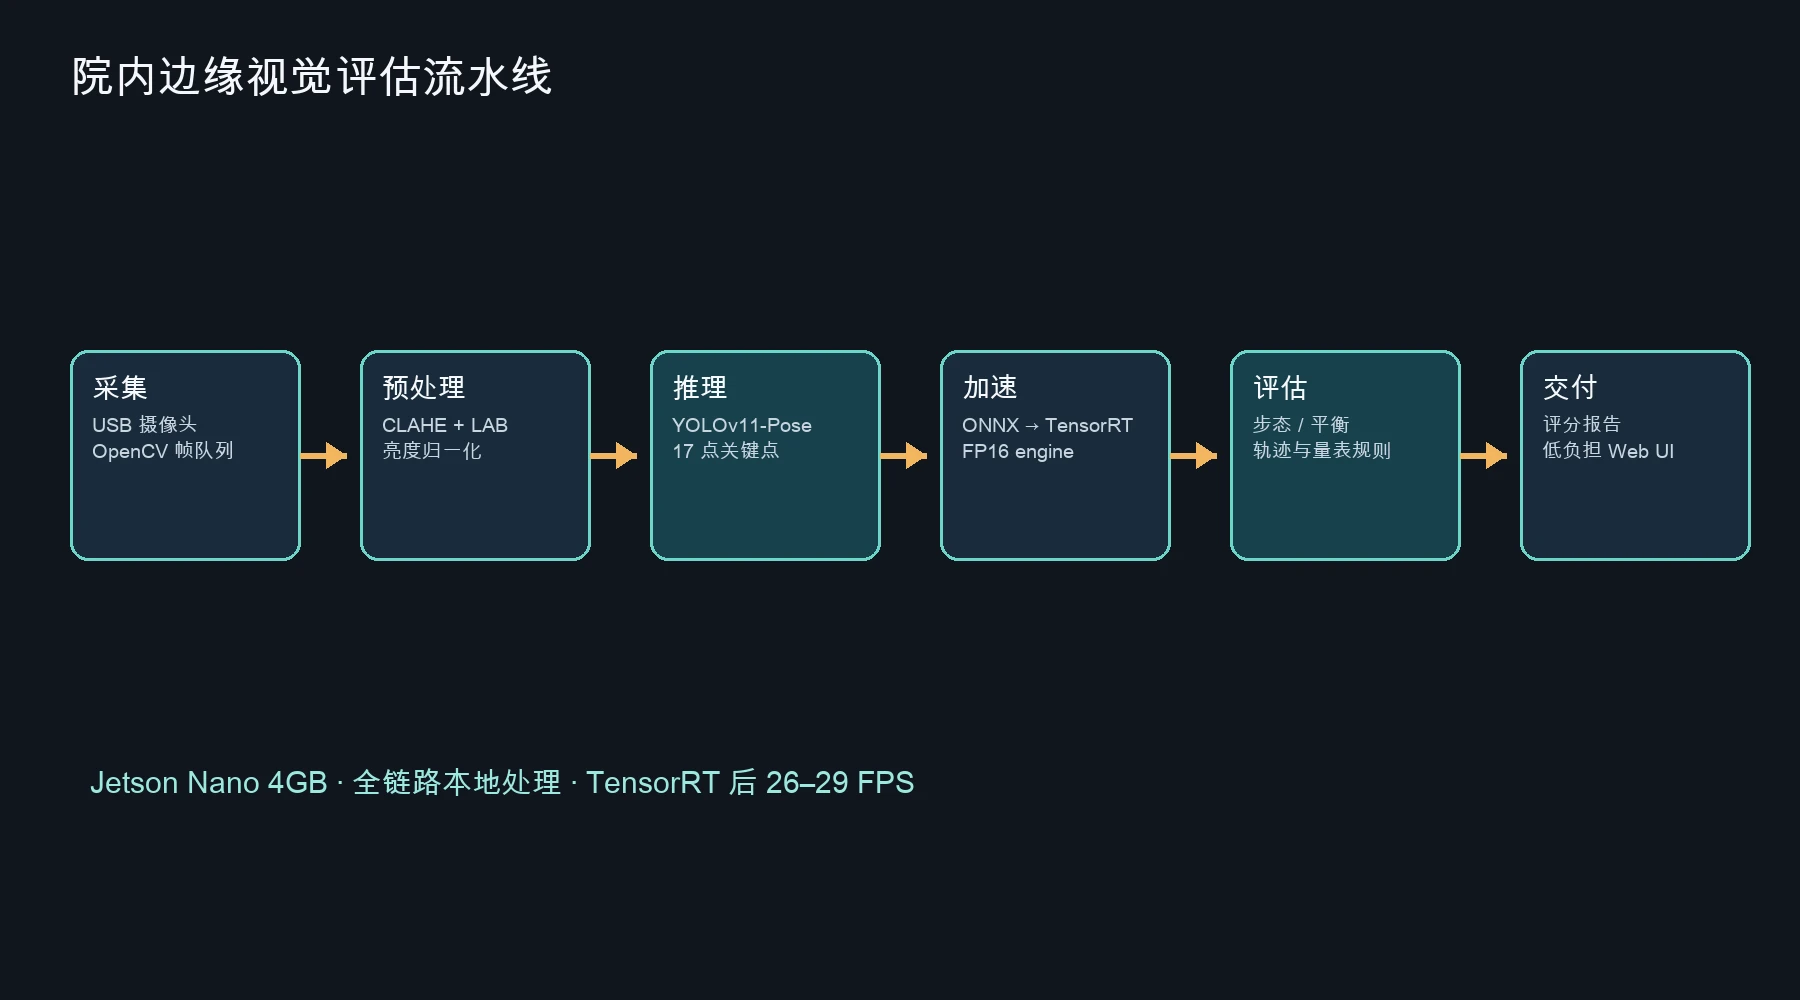
医生在评估界面选择患者和测试项目,USB 摄像头开始采集视频。Jetson Nano 在院内完成全部推理,不上传患者视频:OpenCV 负责帧读取和时间戳管理,模型输出 17 个人体关键点及置信度,规则引擎再把关键点序列转换成步态、平衡和起身动作指标。系统生成 Tinetti 量表辅助评分与报告,医生可以查看原始轨迹、低置信度提示和最终分项结果。
技术实现
采集和预处理
摄像头帧进入有界队列,避免网络或推理抖动时无限堆积内存。预处理阶段使用 CLAHE 改善局部对比度,并在 LAB 色彩空间对 L 通道归一化,降低康复室日光灯和窗边自然光造成的色温变化。每一帧同时保留时间戳和关键点置信度,后面的步频和轨迹计算不能只依赖帧序号。
姿态推理
模型选择 YOLOv11-Pose,是因为它在单阶段检测中同时完成目标定位和关键点回归,适合 Jetson Nano 的低功耗限制。输出为 17 个标准人体节点,每个节点包含 x、y、confidence。工程上没有把低置信度点强行补成“看起来完整”的骨架,而是把它们标记为不可靠,进入报告和界面提示。
TensorRT 优化
最初直接运行 PyTorch 模型时,Jetson Nano 4GB 共享内存很快成为瓶颈。最终流程是:PyTorch 权重导出 ONNX,在 Jetson Nano 本机使用 TensorRT 生成 FP16 engine,再由 OpenCV/推理服务加载固定 engine。engine 必须在目标设备上生成,因为 PC 端 TensorRT 版本和 Nano 上的 8.x 运行时不兼容。
原生推理约 14 FPS,TensorRT 后达到约 26–29 FPS;显存占用从约 2.7GB 降到约 1.2GB,关键点坐标误差控制在 6 像素以内。系统因此有足够余量处理视频采集、规则计算和报告渲染。
从量表文字到可计算规则
Tinetti 的难点不在公式,而在语义。比如“步态对称”不能直接等价成某一帧左右脚距离相等,而要在连续步态周期里比较左右步幅偏差;“躯干稳定”则通过肩部中点的横向轨迹标准差判断;“起身成功”需要识别坐姿到站姿的状态转移,而不是只看某一帧膝盖角度。
步态连续性也经历过返工。最初把脚踝速度接近零当成停顿,但医生指出老年人短暂减速调整重心是正常现象。最后改为统计步频的标准差:节奏稳定时方差低,犹豫和断续时方差升高。每一条阈值都需要医生用真实案例复核,不能只凭开发者直觉确定。
现场难题
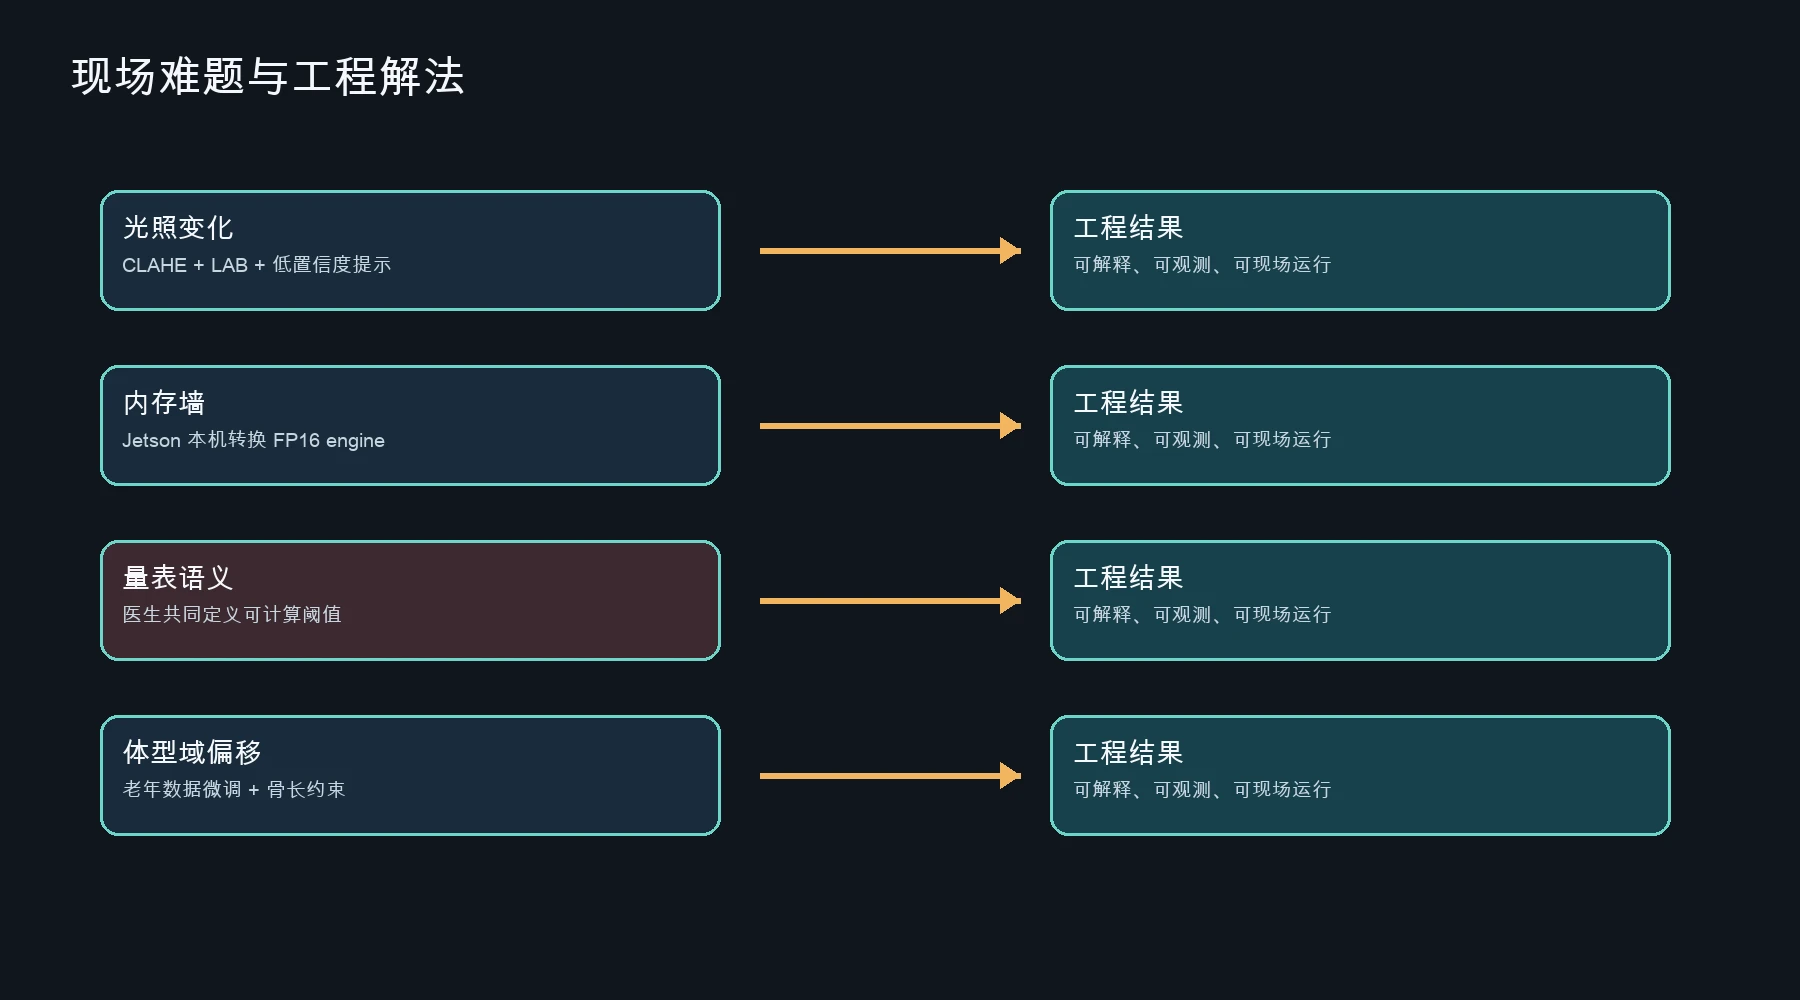
光照变化。 腕部和踝部面积小,下午的暖光会明显拉低置信度。CLAHE、LAB 归一化和低置信度提示共同解决了“模型给出一个看似完整但实际不可靠的结果”。
内存墙。 CPU 与 GPU 共享 4GB 内存,系统本身已经占用约 1.5GB。FP16 engine、固定输入尺寸和有界帧队列让推理在设备上稳定运行。
临床语义鸿沟。 医生说“走得稳”,工程代码必须知道是看躯干摆动、步频波动还是脚步对称。项目采用现场跟诊、示例回放和阈值复核的方式,把自然语言标准转成可解释指标。
体型差异。 老年患者可能存在驼背、关节变形和明显身高差,通用姿态数据的分布并不匹配。项目采集约 200 组院内片段做小规模域适应,并加入髋、膝、踝的骨骼长度约束,预测违反人体比例时触发修正或降低结果可信度。
交付结果
系统在医院完成两周试运行和康复科验收,关键动作识别与医生人工评分的吻合度约 89%,单次评估平均约 6 分钟,连续运行 72 小时无崩溃。它没有取代医生,而是把重复的观察、记录和计算变成一套可追溯的辅助工具:模型负责提取证据,规则负责计算指标,医生负责解释和最终判断。