假设你接手了一个陌生的代码仓库,想先做一轮架构摸底。认证、存储、任务队列和前端入口各有一套逻辑,你希望有人分别阅读,再把发现汇成一张依赖地图。
最开始,这件事像一次普通问答:让 Agent 看认证模块,等它回答,再让它看存储。几个模块过后,你开始觉得不对劲。主 Agent 的对话里堆着越来越多的中间材料,它既要读代码,又要记住谁还没完成,还得决定下一步叫谁。真正需要理解的架构问题,和安排工作的琐事混在了一起。
于是,一个很自然的念头出现了:能不能让模型先写一小段程序,把已经明确的分工、等待和汇总交给代码?
DeepSeek Harness 的 workflow 就在处理这个问题。这里讨论的是一个假设的仓库分析任务,不是官方案例或性能测试。源码固定在 dsh-v0.1.1-rc.2 对应提交;本文只研究这套实现里的子 Agent 编排,不把它扩展成任意工具的通用执行系统。版本源码
主 Agent 先把分工写下来
上一篇看过服务接口和插件装配,这次可以顺着一个真实消费者走进去:tool-workflow 向模型提供 workflow 工具,接收 script、meta 和可选的 args。身份信息放在独立的 JSON 字段里,脚本只写普通 JavaScript 函数体,可以使用顶层 await,最终 return 一个 JSON 值。
这样的分离很实际。名字和说明不必混进代码解析,脚本也不用同时扮演配置文件。引擎会先验证元信息、预解析函数体,并检查子 Agent 提供者和数量上限;无法开始的请求会直接报错,不会先制造一个看似已经启动的运行记录。工具入口、启动校验
我们的示意脚本可以先长这样,args.modules 由调用者传入。它展示编排方式,不承诺仅靠一句提示就能得到可靠的架构结论:
phase("阅读模块");
const notes = await parallel(
  args.modules.map(name => () => agent(
    `阅读 ${name} 模块,说明入口、依赖与需要核实的疑点`,
    { label: name }
  ))
);
return args.modules.map((name, i) => ({
  module: name,
  status: notes[i] === null ? "failed" : "completed",
  notes: notes[i]
}));
主 Agent 发出的是一次编排请求,脚本内部可以等待多个子 Agent,再只把选定的最终结果交回来。这减少了主对话亲自搬运中间材料的需要,但没有消除子 Agent 的模型调用成本,也不保证更省 token。这个版本还把使用指导写进工具提示:只有用户明确要求 workflow 或大规模多 Agent 编排时才使用,一两次委派优先用普通子 Agent 调用。使用指导与结果封装
谁在工作线程里,谁还留在宿主里
容易想象错的一点,是把 workflow 当成“把所有 Agent 塞进另一个线程”。实际搬过去的是编排脚本。每次运行创建一个 Node worker,脚本在其中的 vm 上下文执行;真正的子 Agent 仍由宿主侧 ctx.subagents 启动。
脚本调用 agent(),worker 发出启动消息,宿主通过提供者创建子运行,再把句柄身份和结果消息传回来。这个桥接让脚本可以像等待普通 Promise 一样等待结果,同时把 Agent 生命周期留在 Harness 的服务体系里。线程桥接实现
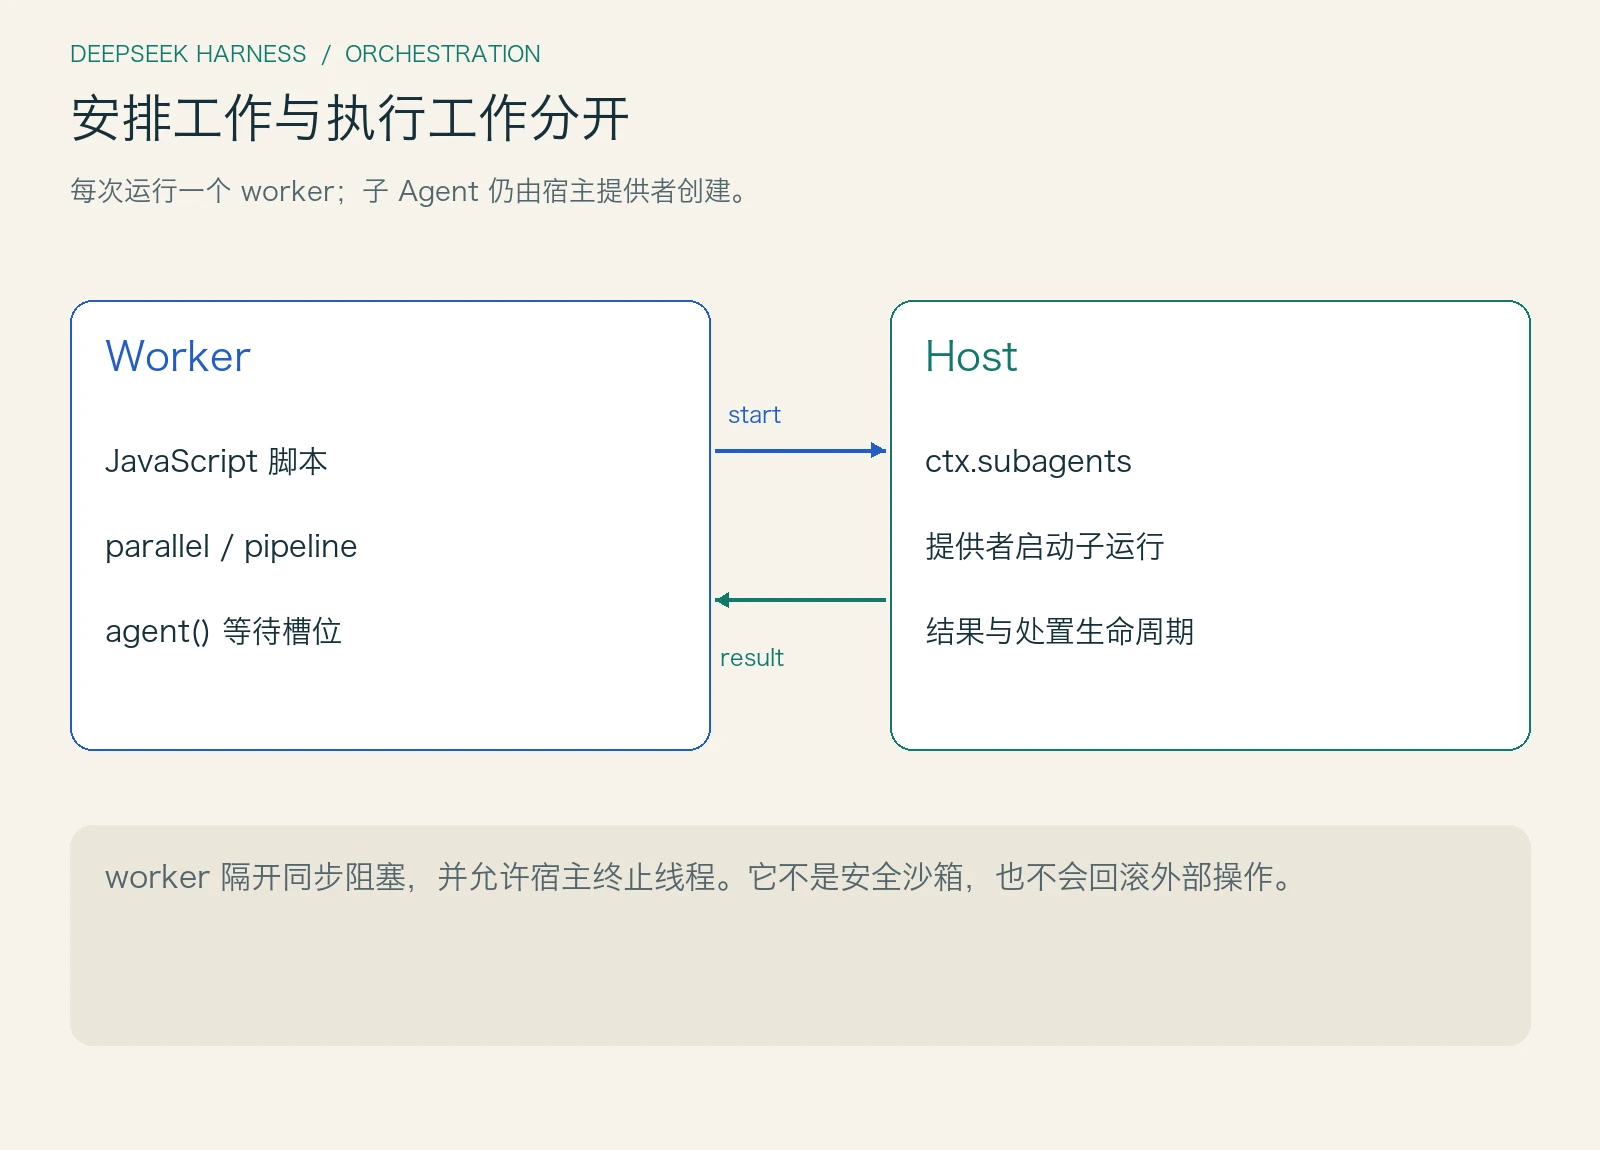
它解决了一个具体故障:脚本进入同步死循环时,不应把 Harness 主事件循环一同卡住。宿主还能终止整个 worker。不过,这不是安全沙箱。官方明确说明 node:vm 可以逃逸,脚本可能获得宿主进程权限下的 Node 能力;没有主动注入文件或网络接口,也不能当作安全隔离证明。若部署要运行真正不可信的脚本,需要在同一个 WorkflowEngine 接口后面换更强的隔离实现。信任边界说明
同时排队,不等于同时启动
回到仓库分析。假如现在有二十个模块,parallel() 会不会一口气启动二十个 Agent?
它的实现比这个问题更细。parallel() 首先检查参数和条目数量,然后对每个零参数函数启动异步执行,用 Promise.all 收集结果。真正的子 Agent 并发上限位于 agent():有空位立即占用,没有空位进入 FIFO 等待队列。一个调用完成子运行的处置后,才释放槽位并唤醒下一个等待者。运行时调度
所以,被限制的是活动中的 agent() 调用,不是所有 JavaScript 函数。纯计算、普通 Promise 或脚本自己制造的其他工作,不会自动获得一套通用任务池。即使某段简介把它概括成受限并行,读到这里也应该保留这层区别。
配置里还有三个不同的刻度。maxConcurrentAgents 管同时占用的槽位,默认零会折算为 min(16, max(1, availableParallelism() - 2));maxTotalAgents 默认 1000,管一次运行接受的调用额度;maxItemsPerCall 默认 4096,管一次组合器接收的条目数。CPU 数量推导只是默认策略,不能据此推断模型服务的配额或最佳吞吐量。配置与解析
总额度在等待槽位之前递增。二十个调用可以先占二十份额度,却只有少量真正进入宿主启动流程。因此正常返回的 agentsStarted 也不能简单理解为成功完成数;如果 worker 被强制终止,宿主只能报告自己观察到的启动请求,统计口径还有不同。做费用估算时应回到真实模型用量,而不是把这个数字直接乘上单价。计数位置、终止路径限制
快的模块,不必等慢的模块
接下来想给每份模块笔记再做一次交叉检查。最直觉的写法是:全部读完,再全部检查。但认证模块也许很快,存储模块却要追踪一整套事务流程;让认证笔记等着,只是因为它们被放进了同一批。
pipeline(items, ...stages) 采用另一种执行顺序。每个条目有自己的阶段链:这一项第一阶段完成,就进入这一项第二阶段。不同条目之间没有阶段屏障。实现依旧用 Promise.all 保持最终数组和输入顺序一致,但数组顺序不代表完成顺序。pipeline 实现
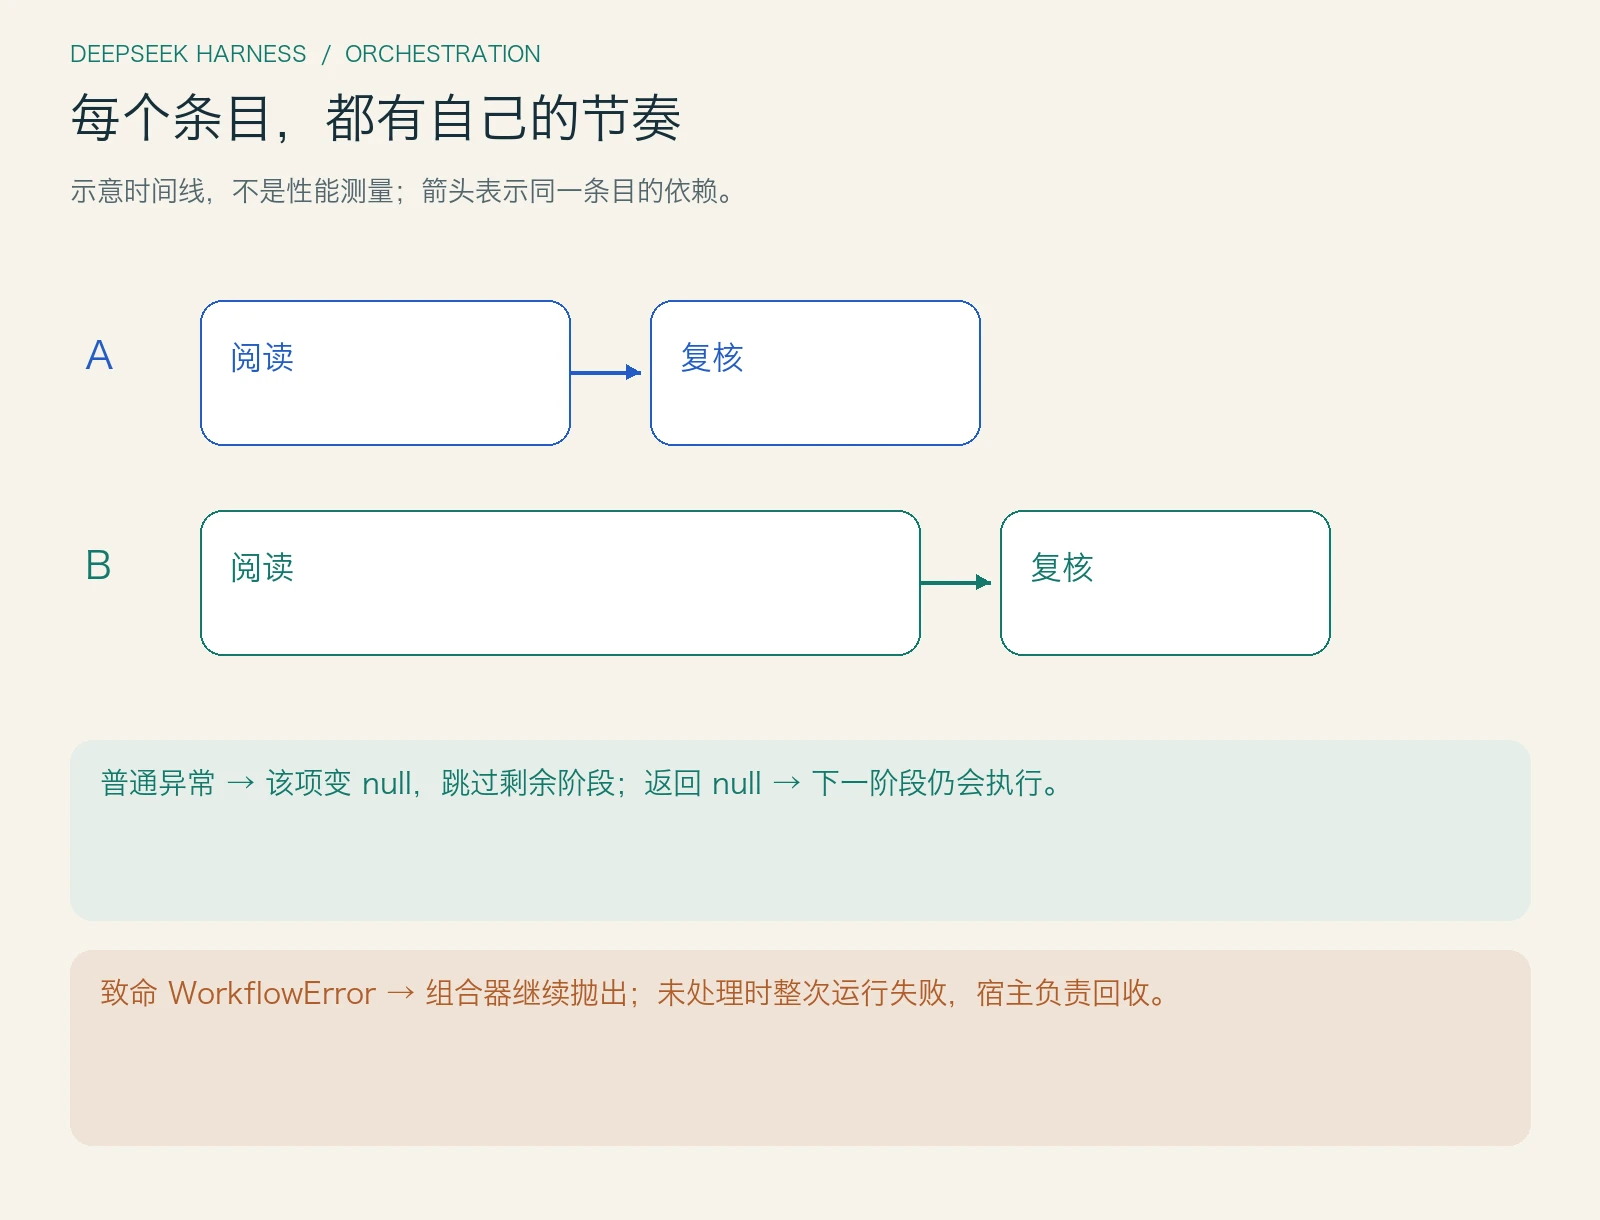
这适合“各模块阅读后分别复核”。如果复核必须看到所有模块的阅读结果,就需要先显式等待第一批,再启动下一批;不能靠 phase("复核") 制造屏障。phase() 只更新后续调用使用的展示标签并通知观察者,没有调度含义。并发分支还会共享这份当前标签,需要精确归属时,应给 agent() 显式传 phase,避免把界面分组误认为执行关系。阶段与标签
一个模块没读懂,应该停掉整批吗
如果一个子 Agent 正常返回了失败状态,agent() 会给脚本 null。parallel() 遇到某个任务函数抛出普通异常,也把那一项变成 null,保留其他项。这让仓库摸底可以交回“哪些已完成,哪些待补查”,而不必因一个角落的失败丢掉全部成果。
但不是任何错误都能吞掉。参数写错、不支持的选项、条目或调用额度超限、提供者启动失败,以及子运行结果 Promise 意外拒绝,会走致命的 WorkflowError 路径。组合器会继续抛出,让脚本的未处理错误最终变成整次运行的失败。任务没做好,与执行基础设施出了问题,不能用同一个空值糊过去。错误分类、捕获位置
这里还有一个很隐蔽的差别。pipeline() 中某阶段抛出普通异常,会跳过该项剩余阶段;但某阶段返回 null,下一阶段照常拿到这个值。子 Agent 的普通失败恰好就是后一种。因此在复核阶段,应先判断前一阶段是否为 null,决定返回失败记录还是继续处理。也不宜随手 .filter(Boolean):如果阶段合法结果包含零、空字符串或 false,它们同样会被过滤掉。
一次致命拒绝也不会让 JavaScript 的 Promise.all 自动撤销其他分支。运行时负责判定结果,宿主在运行终止时关闭新任务入口,取消待启动工作并开始处置已发布子运行。错误传播和资源回收是配合完成的两件事。宿主终止处理
按下停止以后,还剩谁在跑
一次正常运行里,run.result 以结果对象兑现,通过 stopReason 区分完成、错误和取消,而不是靠拒绝表达这些结局。工具层再把非完成状态转成模型能看到的工具错误,并在 finally 中等待 run.dispose()。
取消路径也没有把全部希望寄托在脚本配合上。宿主记录第一个取消原因,通知 worker,同时中止所有待启动和已发布子任务共享的信号。worker 拒绝排队者,后续钩子调用也会报告取消。若脚本仍不结束,宿主等待配置的宽限期,再强制结算并终止线程。结果和清理、宿主取消
默认的 syncTimeoutMs 是初始同步片段的 VM 超时,并不是整段异步脚本的总时限。另一个 disposeGraceMs 才负责取消、处置时的等待边界。两者默认都为 5000 毫秒,名字和数字接近,职责却不同。线程被终止也不等于外部副作用回滚;远程操作能否停止,仍取决于子 Agent 提供者及其工具如何响应取消。
最后,脚本返回值还需要通过普通 JSON 数据检查。循环引用、非有限数、函数以及嵌套的 undefined 等会被拒绝,避免越过线程边界时悄悄变形。没有返回值则被运行时转换为 null。主 Agent 收到的是整理后的最终值,而不是全部中间上下文。值转换实现
把这些规则放回开头的任务,汇总结果最好保留模块名、成功或失败状态,以及仍需核实的问题。只返回一个漂亮的总结,容易把失败项藏起来;把所有子 Agent 原文全部倒回主对话,又会失去主动整理结果的意义。脚本拥有选择返回内容的机会,也承担保留必要证据的责任。编排器能保证数组如何对齐、错误怎样传播,却不能判断一段架构解释是否真的符合仓库事实。
把安排工作从理解工作里分出来
这次分析最有用的收获,不是“多叫几个 Agent 就会更聪明”。模型仍要提出合理分工,子 Agent 仍要读懂代码,最后的事实仍需核实。workflow 接走的是已经能写清楚的控制逻辑:哪些工作独立、哪些结果有依赖、失败能否局部保留,以及什么时候必须停下来。
为核对文中的关键分支,我把固定提交的 runtime.ts 和 realm.ts 转换后执行,使用受控的子运行替身,完成了 15 项检查,覆盖并发槽位、顺序、局部失败、阶段推进、额度和 JSON 返回值等。这是源码级行为验证,没有运行完整 Harness、真实模型或宿主 worker 的端到端取消链路;线程退出与提供者清理由源码核验支持。
等这一批工作真正做完,一个新的问题就出现了:关闭页面后,哪些事实还能被重新找回来?下一篇继续追踪 Session 的事件记录,看看结果如何变成可恢复、可分叉的上下文。