你让 Agent 排查一个线上报错。它读了日志,翻过几个文件,调用了好几次工具,终于把嫌疑缩小到一处配置。你刚补充一句:“先别改,确认影响范围。”它却像忘了这句话一样,继续沿着旧计划动手。
这种失误看起来像“记忆不好”,但可能是几件完全不同的事:记录还在,只是模型本轮没有看到;旧工具输出太长,把新请求挤出了可用窗口;摘要保留了报错,却把“先别改”写成了过去的任务;或者外部记忆刚召回一段相似经历,反而让当前指令失了焦。要查明原因,得先拆开这些层次。
Hermes Agent 处理这些问题时,不把“记住”当成一个开关。会话记录、长期记忆、发给模型的请求,以及压缩之后的交接摘要,各有不同的生命周期。任意一层做对了,也不能替另一层兜底:保存得再完整,如果模型这轮没拿到正确的材料,回答仍会跑偏。这篇沿着一次逐渐变长的排查,看看它们怎样相遇,也看看压缩算法究竟在保护什么。
第一层:记录还在,不代表本轮全送给模型
先从上篇的会话说起。一条消息被路由到相应会话后,历史可以持久化,下一轮再被载入。但模型有上下文窗口:每次请求带进去的系统提示、工具定义、对话消息和工具结果,都要占空间。历史越长,不能简单地把“数据库里有”理解成“模型正在看”。
Hermes 的提示词装配也不是每次重读一遍所有素材。身份、工具约束、项目上下文、技能索引,以及 MEMORY.md、USER.md 等快照被组织进系统提示;这个提示在一个会话期间尽量保持稳定,方便前缀缓存复用。已有会话还会优先恢复存储的提示。你刚修改了磁盘上的记忆文件,正在运行的会话未必立即在系统提示里看到新版内容。这不是“文件没保存”,而是系统提示的生命周期选择。
长期记忆提供的是另一条路。可选的 memory provider 会在轮次开始时,针对用户这次的问题预取相关内容。它不是把整个记忆库铺进系统提示,而是把召回结果封进 <memory-context>,附到这条用户消息的模型可见内容里。原始用户文本和模型实际收到的内容通过 api_content 分开保存,下一轮回放时仍能拿到当时发出的字节。这样,新增召回内容进入本轮,却不必悄悄改写之前的系统提示前缀。
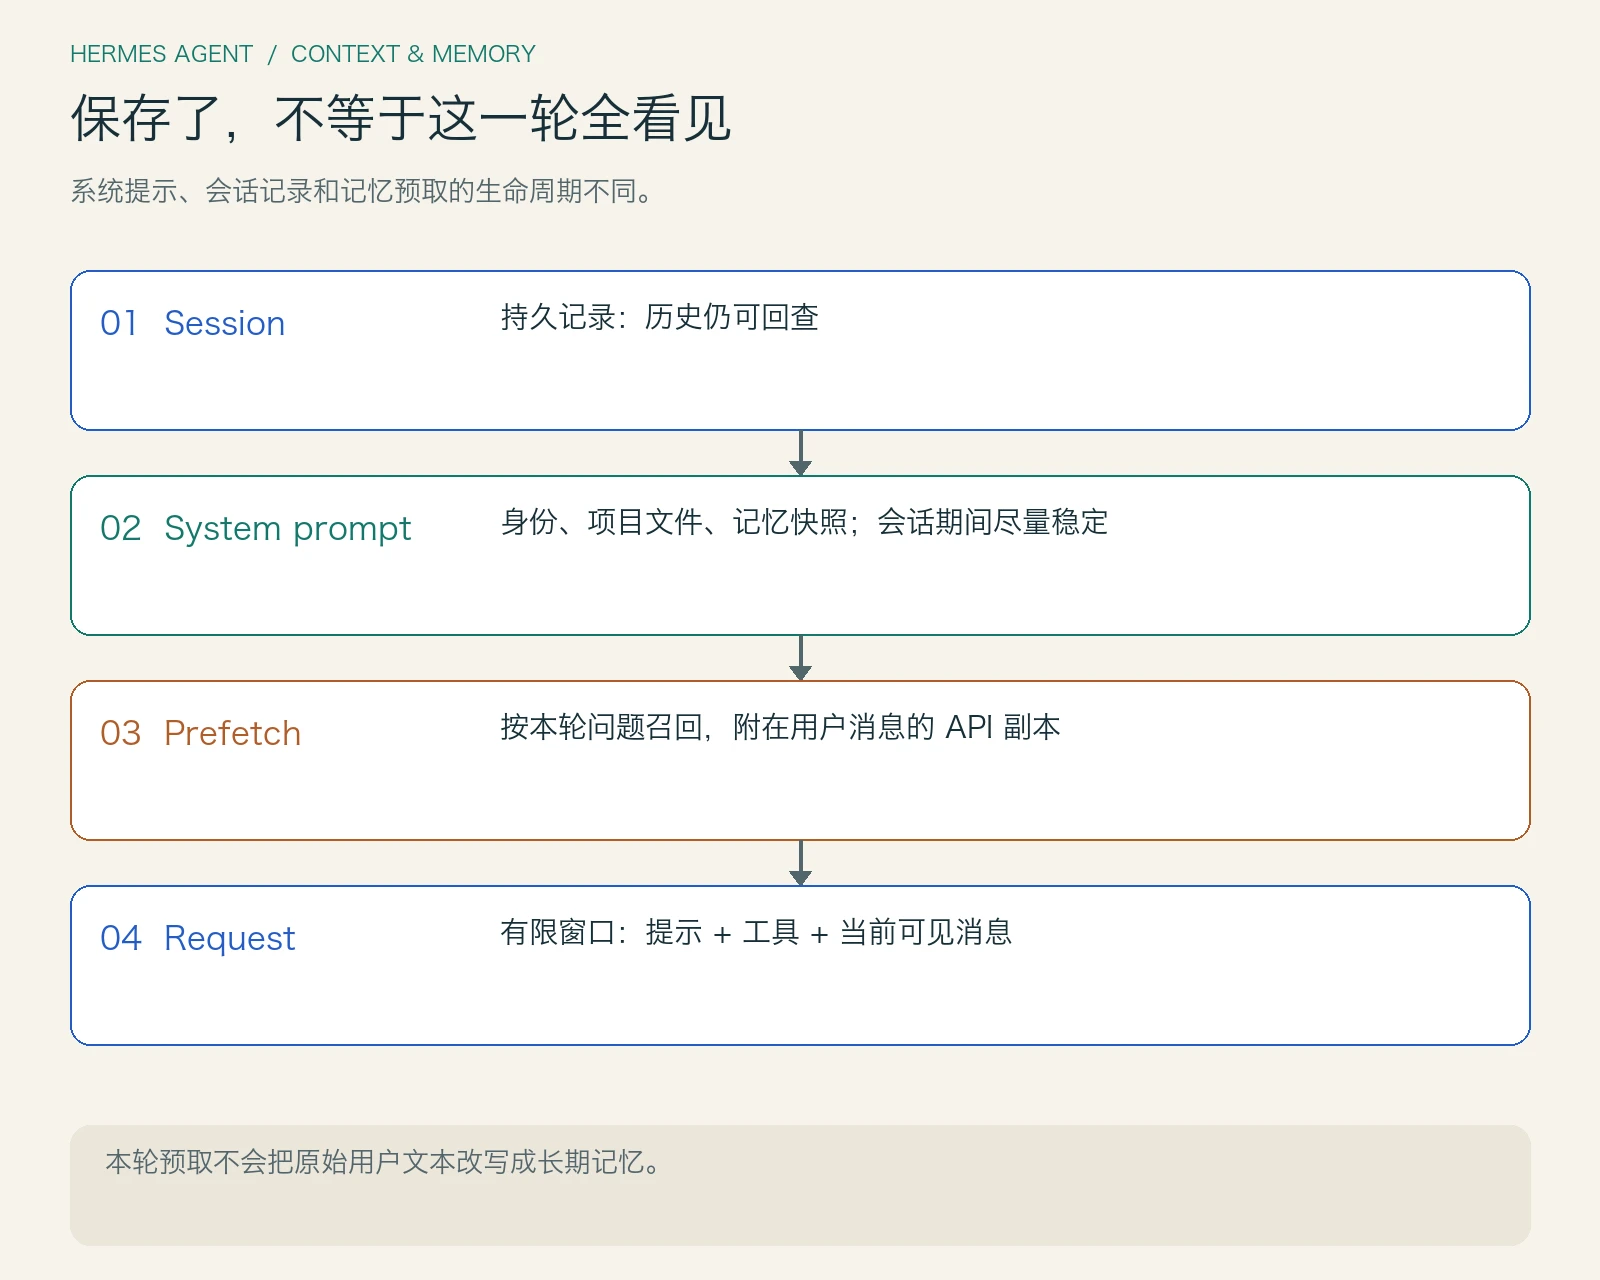
这里还有一个小而重要的代价:召回结果既然跟着用户轮次回放,过大的召回内容就会成为后来每一轮的负担。Hermes 对外部 provider 的预取设置超时;过大的结果可以溢写为文件,只在请求里放预览和路径。provider 卡住时,这轮跳过它,已经卡住的调用未结束前也不会一轮又一轮重新启动。记忆并不是免费附加在上下文之外,它也受时间与空间预算约束。
代码入口可以连起来看:提示词装配、轮次中的预取和 api_content、记忆管理器。provider 是可选能力;不要以为每次聊天都配置了外部记忆。
第二层:先问模型用了多少,再决定何时收拾
继续看那次排查。日志一大段,文件内容又一大段,几次工具返回后,看上去已经快碰到模型窗口上限了。此时最直觉的做法,是把消息字符数除一个常量,当作 token 数,然后立刻压缩。
这个估算有用,却容易被系统提示、工具 schema、图片和某些 provider 的特殊载荷带偏。Hermes 会优先使用模型返回的真实用量作为“锚点”:记住当次请求与回复的 token 数,再粗估那次响应之后追加的消息。锚点还记录当时消息边界的指纹。下一轮重新从数据库读出历史,只要该边界仍匹配,就可以沿用;如果用户编辑了边界消息,指纹不再匹配,旧计数就失效。
这个设计也承认它不知道全部。锚点之后的工具输出仍是估算,指纹验证的是一个已计价的边界,不是为整段历史做密码学证明。没有可靠锚点时,某些轮次的粗估超阈值也会先等模型返回一次实际用量;若 provider 真正报上下文溢出,则进入有次数限制的恢复路径。因此,“50% 自动压缩”只是默认主压缩层的概括,具体还受模型窗口、绝对阈值、配置覆盖和 provider 路由影响。
Gateway 另有一次进入 Agent 前的会话卫生检查,阈值更高,默认约 85%。它是兜底,尤其应对两轮之间会话历史突然增长的情况;Agent 内的 ContextCompressor 才是正常循环中的主要管理者。两层的用量依据、触发时机不同,不能把它们相加成一个单一阈值。
这部分源码分别在 用量锚点、请求装配 与 Gateway 轮次。
第三层:丢掉废纸之前,先圈出不能丢的句子
一旦需要压缩,Hermes 并非把整个聊天交给另一个模型,说一句“帮我概括”。它先处理过时的工具结果:相同内容可以去重,旧的长输出缩成短提示,大块工具参数在保持 JSON 结构的前提下变短,旧图片也有退役策略。这样做可能已经腾出不少空间,而且尚未调用摘要模型。
接着它把消息分成三段:受保护的开头、可以概括的中段、最近的尾部。尾部从新到旧计算预算,边界要顾及工具调用与结果不能被拆成孤儿。它通常尽力保留最后一条真实用户请求,以及最近一次可见的 Agent 回复;可配置保留更多条真实用户消息。这里“真实”很关键:空白的平台回显、压缩交接提示,不应该冒充用户刚刚下达的任务。
在默认的 lean 模式下,尾部不再无限膨胀。系统用较小的原文尾部加一份更有针对性的摘要延续工作:保留任务进展、关键标识、真实用户消息的引用,并留下 session_search 这样的恢复入口。摘要之外的旧会话不等于被物理删除;默认的原地压缩保留同一个 session ID,先前轮次会以已压缩状态留在存储中,供检索和核对。
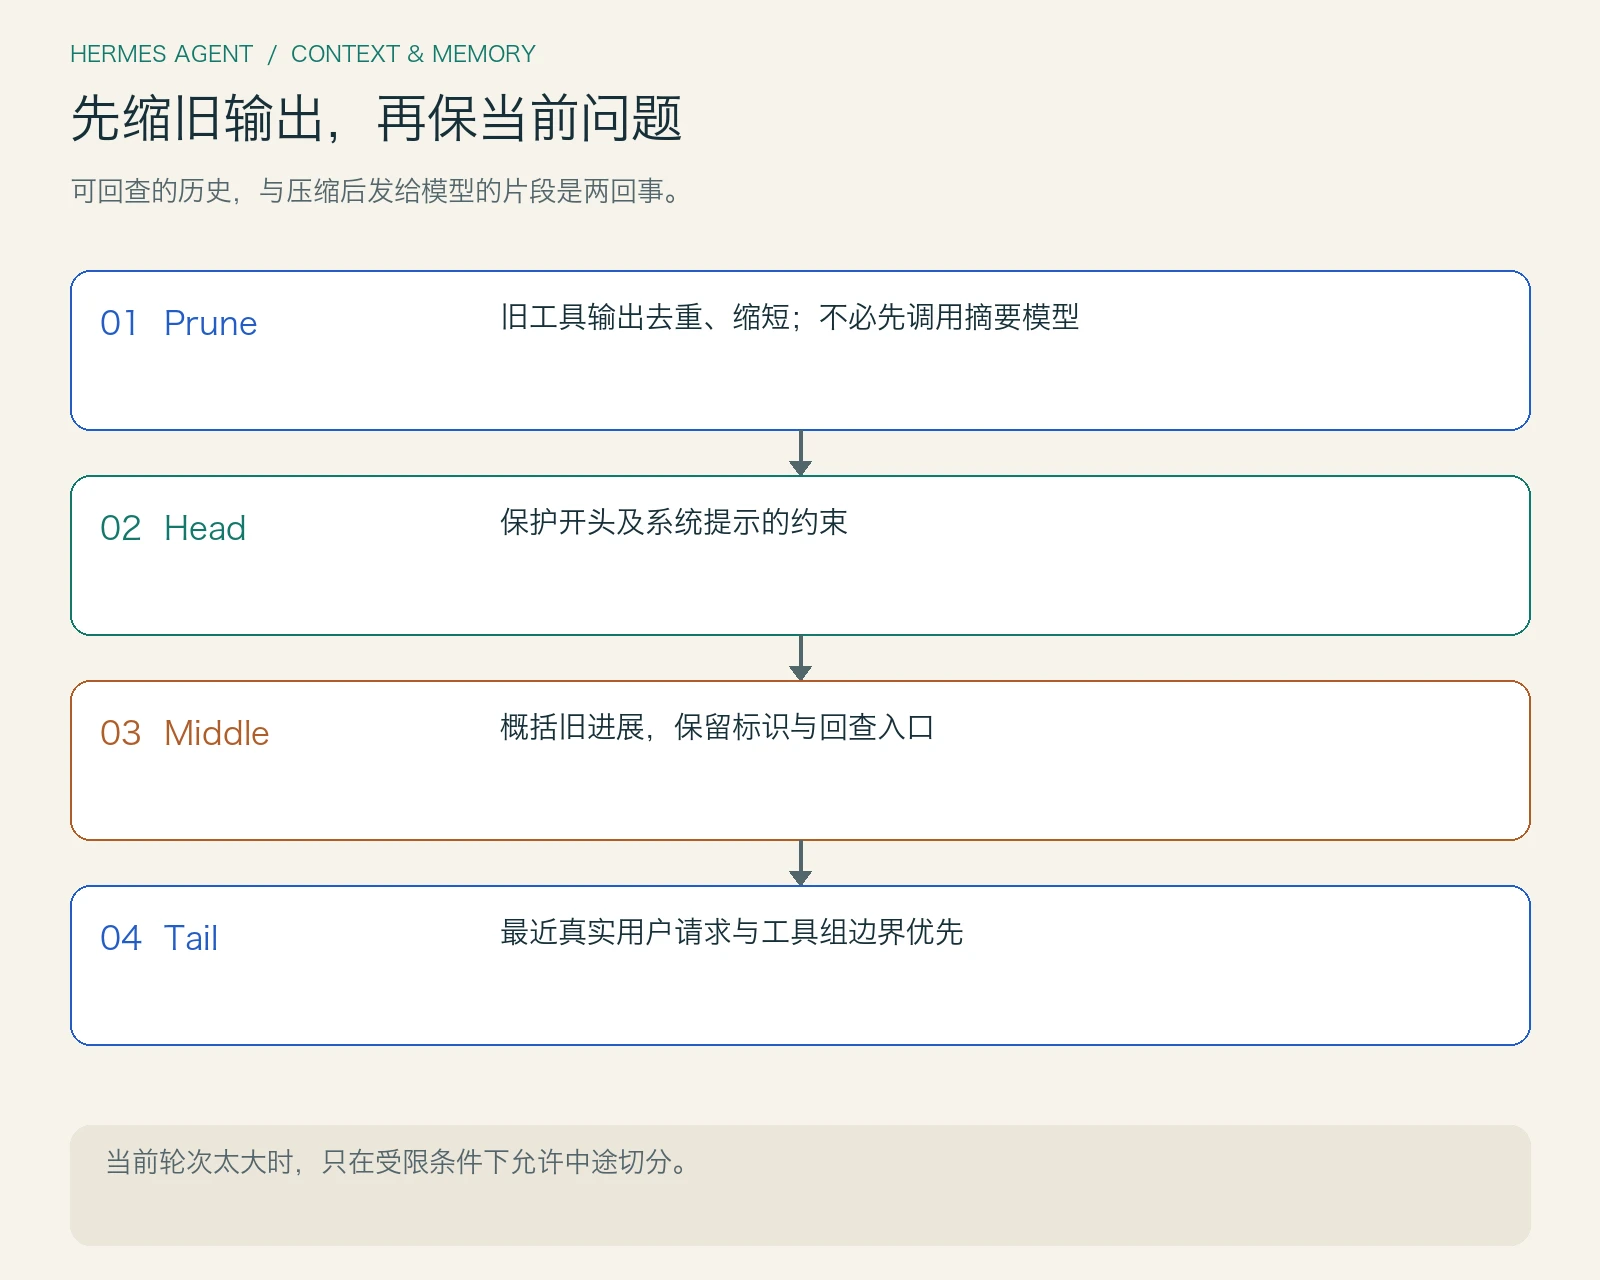
摘要的承载消息还有明确提醒:这是先前工作的参考,不是新用户提出的待办。否则模型看到旧摘要里写着“下一步修改配置”,可能把那句当作比眼前“先别改”更重要的命令。正确的交接应告诉它做过什么,而不是替用户重新发号施令。
这一整段逻辑可在 压缩器 对照。压缩会改变上下文前缀,所以它是提示缓存稳定原则的一个有意例外,而不是可以随意用于“刷新所有记忆”的通用手段。
难题来了:最近一轮本身就大到装不下
上面的保护规则还藏着一个冲突。假设“先别改”之后,Agent 在同一轮里连续跑了很多工具,生成了巨大输出。若算法坚持把这轮开头的用户请求和之后的全部工具链都原样留在尾部,压缩结束后窗口仍可能太大;若直接从轮次中间切,又可能失去用户眼下的目标。
这份源码对这个两难处有一条受限例外。尾部扫描先采用软上限,并对可选消息保持预算;真实用户请求、最近回复和不可拆的工具组可以突破它。只有在当前轮次的锚定区域确实超过软上限、用户请求本身不大、轮次中存在实际工具调用等条件同时成立时,才允许保留一个对齐工具组的中段切点,让开头的请求通过交接摘要承接。配置要求保留多条真实用户消息时,这项承诺仍优先于这个例外。
特别值得注意的是,判断“确实超限”时,它复用同一套尾部扫描计费;某些路由不会反复向模型发送旧推理文本,于是扫描只给最新一次 assistant 的推理计费。如果另用一套更粗的计数,就可能把其实放得下的轮次误判为超大,错误地把当前请求移出原文尾部。对应的 9 月 19 日官方提交 正是在收紧这条判定。
这是我最喜欢的架构细节:边界不是一句“尽量保存最近内容”,而是一系列可检验的约束,既要让压缩真正释放空间,也要让最新用户的“先别改”尽可能保持原话和优先级。
摘要失败时,不能假装成功
压缩依赖的辅助模型也可能超时、拒绝或给出不完整内容。这时策略不是一个笼统的“失败就继续”:有些终止类错误会保留原文并中止;允许降级时,可走确定性的兜底交接;连续失败会进入冷却和防抖,以免每轮都烧掉时间。手动压缩和模型明确报告溢出的恢复路径,又有自己的有限重试规则。
如果采用外部记忆服务,压缩前还可通知它提取有价值的信息。默认通知是尽力而为;只有显式启用 checkpoint_required 且有支持该契约的 provider 成功提交检查点,才会把“先归档证据,再做有损重写”变成强条件。不能因为配置了一个记忆插件,就宣称每次压缩必然完成了可靠归档。并且辅助模型若无法容纳待概括内容,也不能保证得到高质量摘要。
为了核对关键分支,我用固定提交的原始函数做了 21 项局部行为检查:用量边界被编辑后锚点失效,记忆仅进入用户消息的模型副本,旧推理是否重复计费会改变尾部切点。测试替代了记忆包装、预算估算和压缩器宿主;没有运行真实模型、SQLite 提交、Gateway 或整个压缩流程。因此关于提交、冷却与历史可回查的结论来自源码路径审阅,不把局部测试冒充端到端结果。
回到那句“先别改,确认影响范围”。好的记忆系统首先要分清它是什么:它是当前用户的命令,不是从过去召回的参考,也不是摘要中等待重演的计划。会话记录保证还有证据,长期记忆提供线索,用量与压缩决定模型眼前能看到多少;最终还是这些边界,决定 Agent 能不能在长任务里继续听懂你此刻的话。