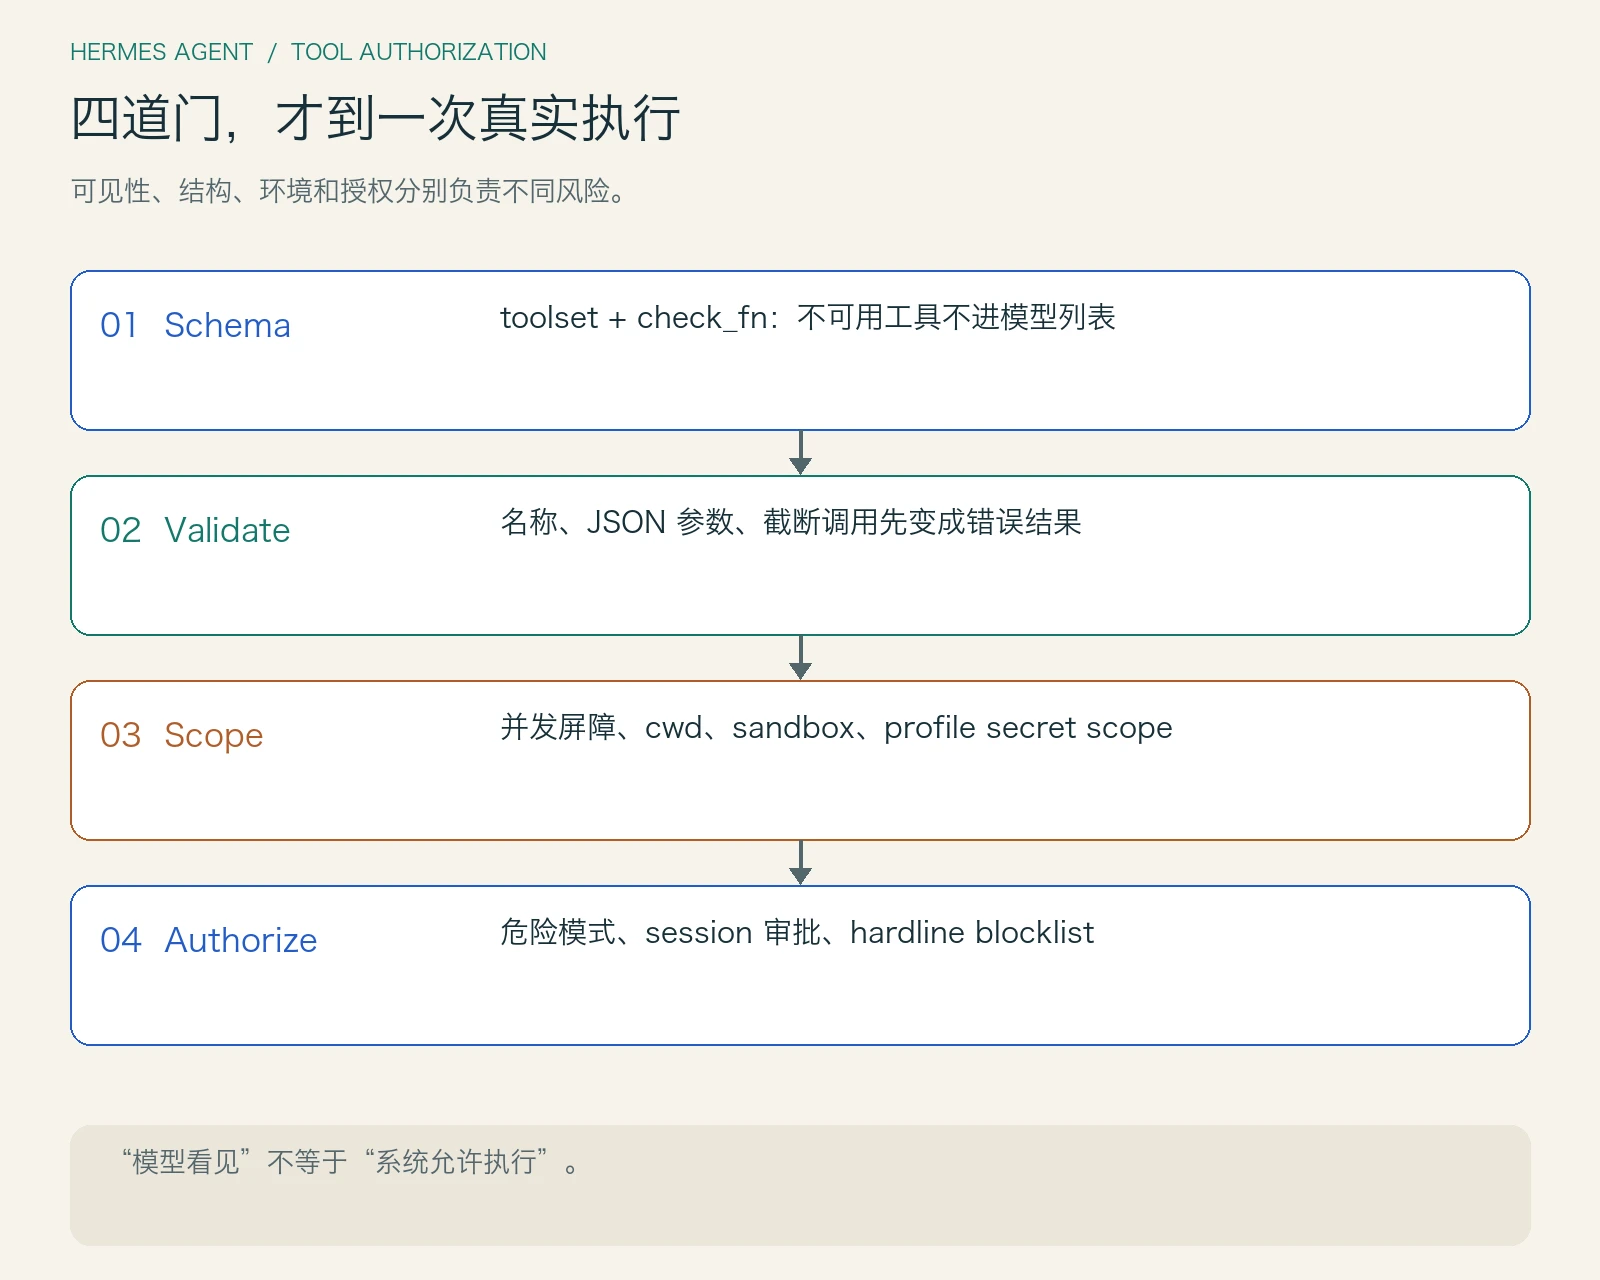
你让 Hermes 帮你清理一个项目目录。它先列出文件,发现 node_modules 很大,然后提出一条看起来合理的命令:rm -rf node_modules。这时真正的问题不是 Agent 会不会写出这行 shell,而是这行字要经过多少道门,最后才可能成为一次真实的进程启动。
如果只看聊天界面,很容易把“模型生成了工具调用”和“工具已经执行”混成同一件事。Hermes 把它们拆开:模型只能从当前可用的工具 schema 里提出请求;调度器再决定是否能找到这个工具、是否允许并发、应该在哪个环境运行;终端命令还要经过危险模式检测、用户审批和硬性阻断。授权不是一个布尔值,而是一条带上下文的路径。
第一扇门:模型能看见什么
一次工具调用从模型返回时,Hermes 先验证名称和参数。未知名称不会被“猜着执行”,而是变成工具错误返回给模型;连续三次仍然无效,当前轮会提前结束。参数必须是 JSON 对象,截断或无法解析的参数不会被当作半成品 shell 运行。
但更早的一层发生在请求发给模型之前。工具注册表里的每个 ToolEntry 可以带 toolset 和 check_fn。生成 OpenAI 格式 schema 时,check_fn 返回 false 的工具根本不会出现在列表里;异常也按不可用处理。enabled_toolsets 和 disabled_toolsets 再决定候选集合,动态 MCP 工具还要经过自己的发现与作用域检查。于是“模型不知道这个工具”本身就是一种权限边界。
这层过滤不是安全授权的终点。一个工具可以被模型看见,却在执行时因为当前环境、路径或审批策略被拒绝。把 schema 暴露当成授权,会把提示层的可见性误当成运行时的能力。
第二扇门:先决定在哪里跑
Hermes 的调度器把工具调用分成可并行和必须串行的两类。只读查询、明确声明支持并行的 MCP 工具,可以进入同一个批次;写文件、修改路径或交互式工具会形成屏障。路径相关的读写还会做重叠检查:两个读者可以共享一棵子树,但写者会和任何重叠保留发生冲突。这样,速度优化不会悄悄改变工具结果所代表的状态顺序。
真正执行前,终端还要绑定本轮的环境策略。terminal_scope 把 profile 的 backend、cwd、sandbox 和生命周期设置放进 context-local scope;解析失败时安装 refusal scope,后续执行直接抛出 TerminalPolicyUnavailable,不会退回到启动进程的环境变量。这个“失败即拒绝”很重要:在多 profile gateway 中,回退到 ambient environment 等于把 A profile 的权限带给 B profile。
凭据也遵循同一原则。多 profile 模式下,secret_scope.get_secret() 没有绑定当前 profile 时会抛出 UnscopedSecretError,而不是偷偷读取 os.environ。绑定的 scope 只提供该 profile 的映射;缺失项返回默认值,不会从另一个 profile 补齐。授权边界因此延伸到了进程内的环境变量,而不只是终端命令文本。
第三扇门:危险命令需要谁来点头
以 rm -rf node_modules 为例,终端在启动子进程前会扫描危险模式。命中后,审批模块根据当前 session、平台和配置选择路径:CLI 可以弹交互式提示;gateway 可以通过回调把请求送到消息平台;smart 模式可以让辅助模型评估低风险例外;无人值守的 webhook、API 或 cron 上下文默认拒绝,因为那里没有一个可靠的人能回答 /approve。
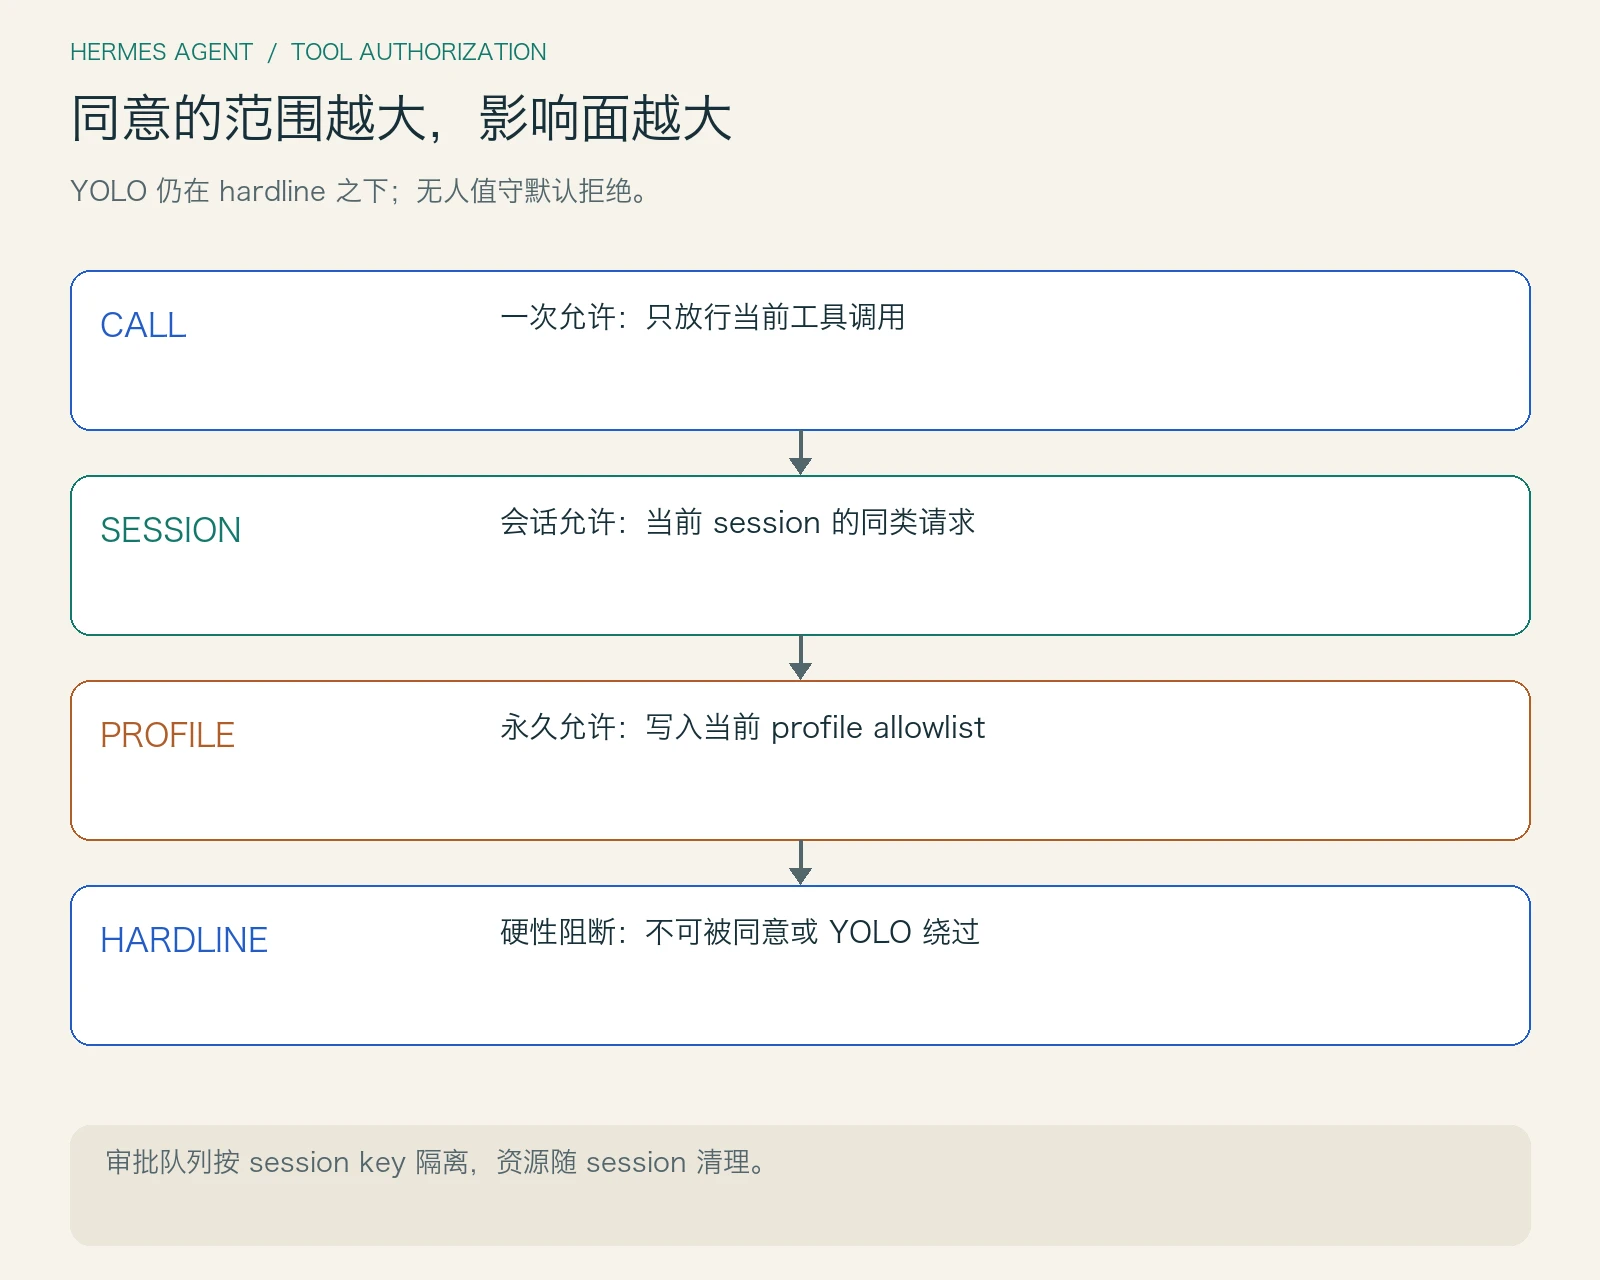
批准也有范围。一次允许只影响当前调用;session approval 只记在当前 session;“永久允许”才写入 profile 的 command_allowlist。审批队列用 session key 隔离,重连客户端只能恢复自己的最早待处理请求。清理 session 时,待审批请求会被取消,相关 kernel 也一起关闭,避免一个已经结束的会话留下可复用的执行资源。
这解释了为什么“让模型自己说我同意”不算授权。模型输出只是触发审批流程的输入,真正的决定来自绑定到平台和 session 的控制面。把 /yolo 当作普通 allowlist 也不准确:它只绕过可绕过的危险命令审批,hardline blocklist 仍然在最前面,fork bomb、格式化设备、不可逆的系统破坏等命令不会因为 YOLO 而获得通行证。
第四扇门:结果回来以后仍要分类
工具返回字符串不代表“成功”。Hermes 会把结果包装回消息,并区分 guardrail refusal、真实错误和已经落地的文件变更。tool_may_have_side_effect() 对未知或插件工具默认按可能有副作用处理,所以取消或中断时不能随便丢掉它们的结果。对于 write_file,只有结果里有 bytes_written;对于 patch,只有 success: true,才算变更落地。
这套分类会反过来影响下一轮。重复读取的 guardrail refusal 虽然包含 error 字样,却不会被错误计数器当成失败;终端非零退出码则会进入失败恢复和循环护栏。连续重复、没有进展的调用最终可能被 warning、block 或 halt。Agent 不是收到一个红色字符串就盲目重试,而是把“拒绝”“失败”“成功但无效”分成不同状态。
一个可迁移的设计结论
如果你要给自己的 Agent 接一个内部 MCP,至少要把四个问题分开回答:工具什么时候出现在 schema;调用由哪个 session 和 profile 发出;执行绑定哪个环境和 secret scope;结果怎样证明副作用已经发生。把它们压成一个 is_allowed(),短期代码少,长期却会失去审计线索,也无法解释为什么同一个命令在 CLI 能问人、在 webhook 却必须拒绝。
Hermes 的实现还有一个值得借鉴的细节:每道门都尽量返回结构化、可供模型继续工作的结果。未知工具会得到明确错误,审批拒绝包含“没有执行”的事实,策略解析失败使用 refusal scope,文件写入只有可验证字段才算成功。这样,Agent 可以调整计划,但不能把一次拒绝叙述成一次成功。
我用固定提交的纯函数和小型替身做了 22 项检查:验证 toolset 的可见性规则、危险命令识别、session approval 隔离、YOLO 不绕过 hardline、secret scope 的 fail-closed 行为、工具结果分类和路径并发屏障。检查没有启动真实 shell、消息网关、辅助模型或 MCP server,因此它验证的是决策边界,不是端到端部署性能。
当 Hermes 说“可以执行”时,真正可靠的解释应该是:模型提出了一个结构正确的请求,它通过了当前工具列表和执行环境的检查,必要的审批由正确的 session 获得,结果也以可验证的状态回到了对话。少掉其中任何一层,Agent 都可能看起来很聪明,却把权限问题藏在一句自然语言里。