Jev:把 Agent 的判断从文本生成里拆出来
很多 Agent 的瓶颈并不是不会写答案,而是每一步都要让一个通用语言模型先生成一段话,再从话里解析出“该不该做、选哪个、置信度多少”。Jev 的核心思路正好相反:给定状态、问题和候选集合,直接返回类型化的决策。
先把 Jev 说清楚
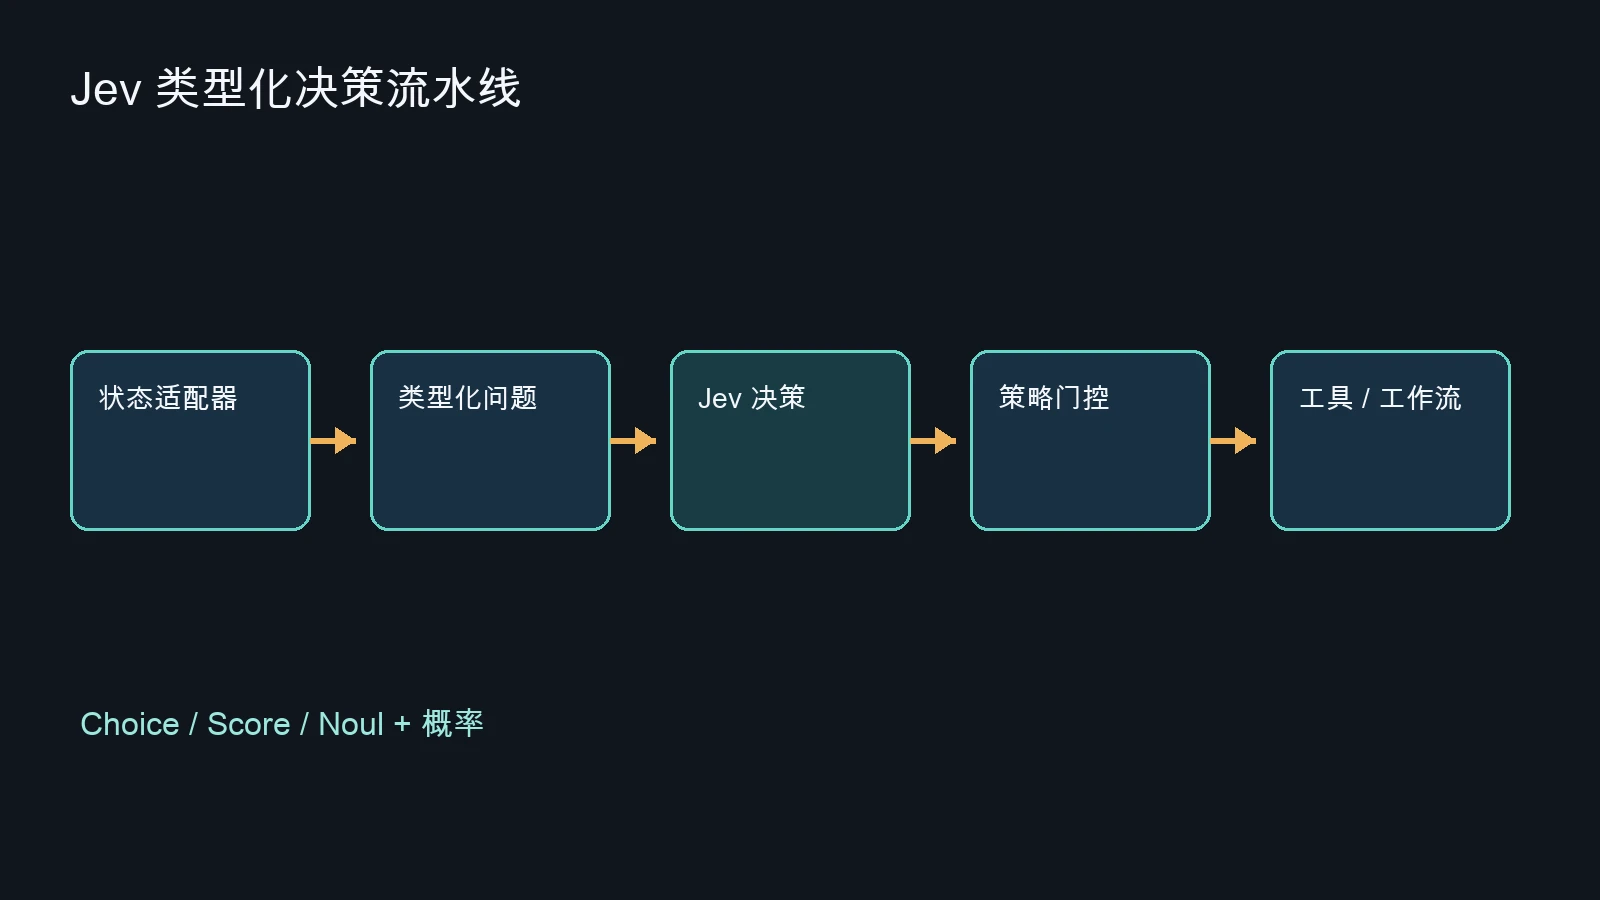
TypeSafe AI 将 Jev 定义为 System One 模型。它不是聊天模型,也不是浏览器自动化框架。输入是一段 state 和一个或多个 typed questions,输出可以是 Choice、Score 或 Noul(是/否/不确定一类的判断),并附带概率。Jev 的模型权重和托管推理服务是闭源的;社区的 Open-Jev 是独立复刻,不能当成官方模型的开放权重。
这一区分决定了工程边界:Jev 适合做路由、筛选、审批前判断、工具选择、质量打分和工作流分支;长文本写作、代码生成和开放式规划仍然应该交给通用 LLM。
技术关键:输出空间先于提示词
典型的调用可以抽象成:
result = client.ask(
    state="订单到货时外包装破损,客户要求退款",
    questions={
        "refund_requested": {"type": "noul"},
        "route": {"type": "choice", "criteria": {"billing": "退款与收费", "support": "物流与售后"}},
        "frustration": {"type": "score", "criteria": ["平静", "不满", "激烈"]},
    },
)
应用先定义问题的类型和候选,模型只负责在这个空间里做判断。这样可以消除 JSON 解析、枚举值拼写、额外字段和“模型自创工具名”等一整类故障。概率也不等于正确性证明:它更适合作为阈值、人工复核和多模型路由的信号,仍需要校准集和拒答策略。
与开源路线的横向比较
OpenAI/Anthropic structured tool calling 让通用模型生成符合 schema 的调用,覆盖面广,但仍然是自回归文本生成后再约束格式。Jev 把“判断”本身作为服务对象,输出 token 更少,适合高频小决策;代价是问题必须预先类型化。
Open-Jev 公开了 2B、9B 和 27B-v1.1 的 LoRA、决策头、校准温度、数据集和工作台。它展示了一个可自托管的实现路径:基础模型负责表示,训练出的 scalar decision head 负责评分,温度参数负责概率校准。项目 README 明确写着它不复刻 TypeSafe 的私有 RLCD、权重或训练数据,因此更适合作为研究基线。
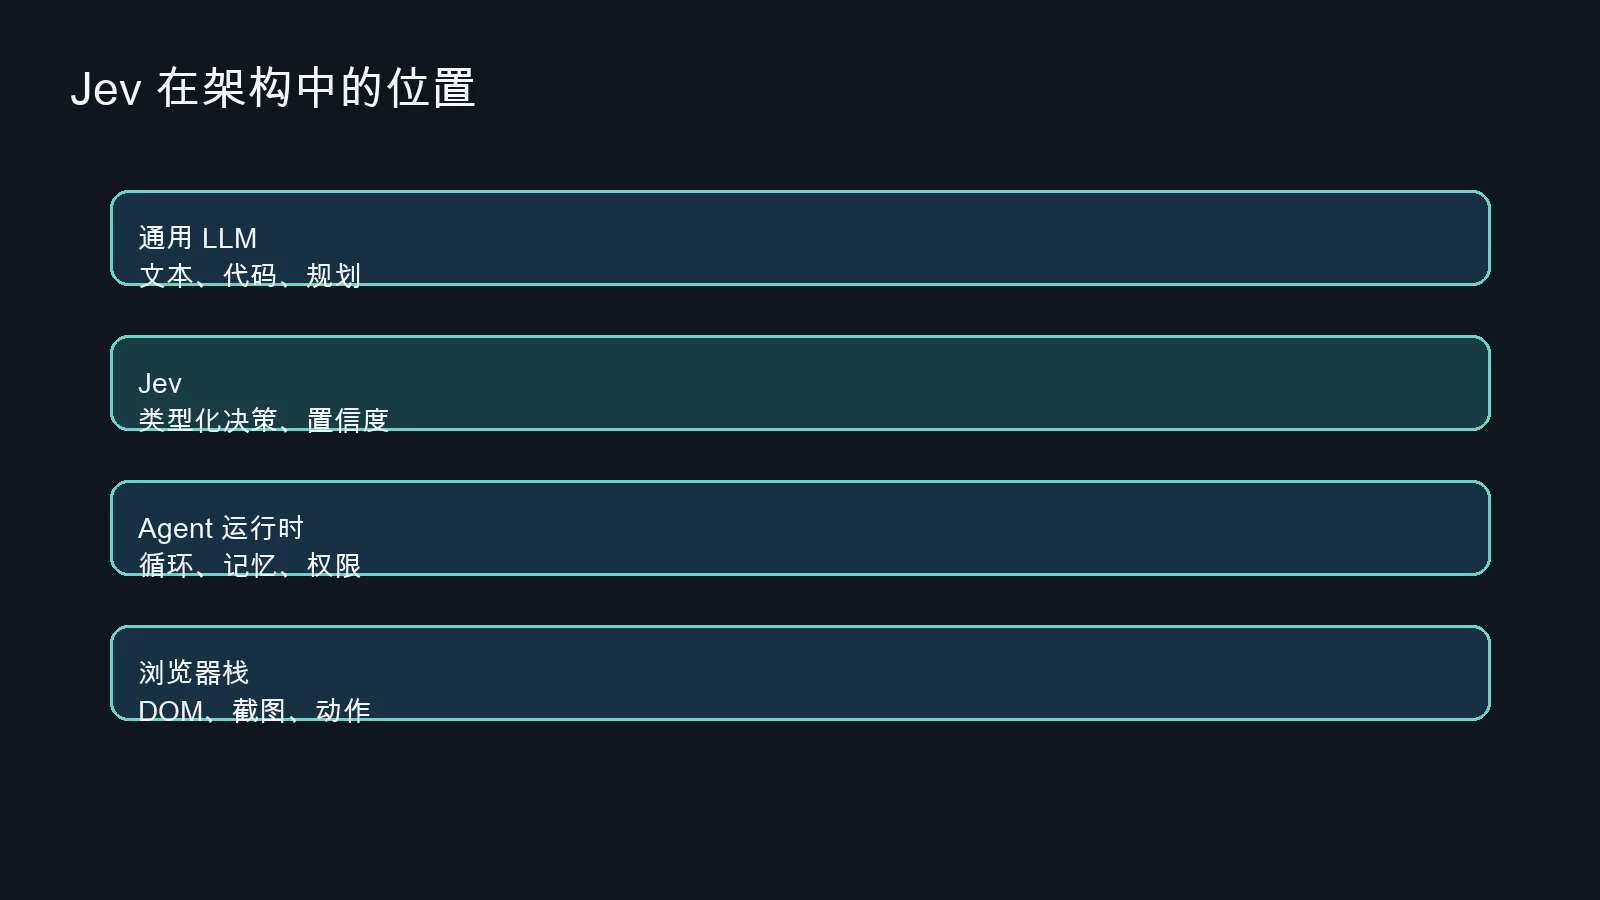
browser-use、BrowserGym/OSWorld 解决的是“如何观察网页并执行动作”。它们拥有浏览器状态、DOM/截图、动作执行器和评测环境;Jev 更像其中的决策内核,可以判断“是否需要确认”“应该点击哪个候选”“任务是否已经完成”,但不会替代浏览器驱动器。
SWE-agent、OpenHands、Hermes 更接近完整 Agent:它们负责循环、工具、终端、记忆、权限和恢复。把 Jev 放进这些系统,合理的位置是快速门控层:先用低成本 typed decision 过滤工具候选、评估风险或判断是否升级到昂贵的推理模型,再让主 Agent 执行复杂步骤。
一个可落地的组合架构
在实际系统里,可以把一次 Agent turn 拆成四个阶段:状态压缩、Jev 门控、主模型规划、执行与验证。Jev 的输入不要直接塞整页 HTML 或全部日志,而应由适配器提取稳定特征:候选工具、目标实体、风险标签、最近一次结果和可观测的完成条件。输出则进入显式策略:低于阈值时人工确认,候选接近时交给主模型,明确拒绝时结束当前分支。
这比把 Jev 当成“更快的 GPT”更准确。它的价值来自接口契约和延迟预算:决策问题越窄、调用越频繁、失败代价越高,typed decision 越有意义;需要解释长链路、生成新代码或处理开放世界信息时,通用模型仍是主力。
自托管与评测要点
如果目标是完全可控的内网部署,Open-Jev 提供了可研究的起点,但要固定基础模型 revision、候选顺序、上下文长度和校准温度。评测不能只看 top-1 accuracy,还要记录概率校准、拒答质量、候选集合变化、P50/P95 延迟以及错误决策的业务代价。尤其要区分“选对了”与“概率可信”:前者适合路由,后者才适合自动放行。
Jev 的真正启发不是再造一个更大的聊天模型,而是把 Agent 中大量隐含的 if/else 重新建模为可观测、可校准、可替换的决策接口。这样,闭源 API、Open-Jev、传统分类器和规则引擎可以在同一个契约下互换,系统也不必把每个小判断都交给最昂贵的生成模型。
技术资料:TypeSafe Jev 官方项目页、Jev Agent API 说明、Open-Jev 源码与模型、BrowserGym、browser-use、OpenHands。