会议刚结束,你把纪要放进工作目录,给 OpenClaw 发了一句话:
读一下
notes/meeting.md,把会议里需要我做的三件事列出来。
屏幕上先出现“我先看看会议纪要”,随后文件读取完成,最后是一份整理好的待办清单。看起来很自然:你提要求,它去做,然后交作业。
不过,把这个假设场景放慢,就会看到一个容易被忽略的间隙:文件已经读完了,为什么回答还没有完成? 谁把文件内容交回模型?如果模型只说了“我先看看”,后面就没动静,系统又该不该把这次请求算作成功?
上一篇我们站在 Gateway 门口,看它如何区分“收到请求”和“执行结束”。这一次,跟着这份会议纪要走进去,看看一次 Agent 执行内部发生了什么。
本文以 OpenClaw v2026.5.22 为源码样本,沿它选择内置 Pi harness 的路径展开;这个版本锁定的 Pi 包版本是 0.75.4。OpenClaw 还有其他执行路径,下面这趟旅程不代表所有 harness 的内部实现。版本依赖与执行器选择可以对照阅读。
消息到了,先别急着问模型
先想象一个只用几十行代码写成的助手:收到文字,拼上历史消息,调用模型,然后把结果显示出来。如果模型要求读文件,就读一下,再问一次。对于演示,这已经足够。
但现在这位助手要长期住在你的工作环境里。同一个会话可能同时收到两条消息;上一轮留下了历史记录;工作目录决定“这个文件”在哪里;工具是否可用也不能临时听模型安排。这些事情不会因为换了一家模型服务商而消失。
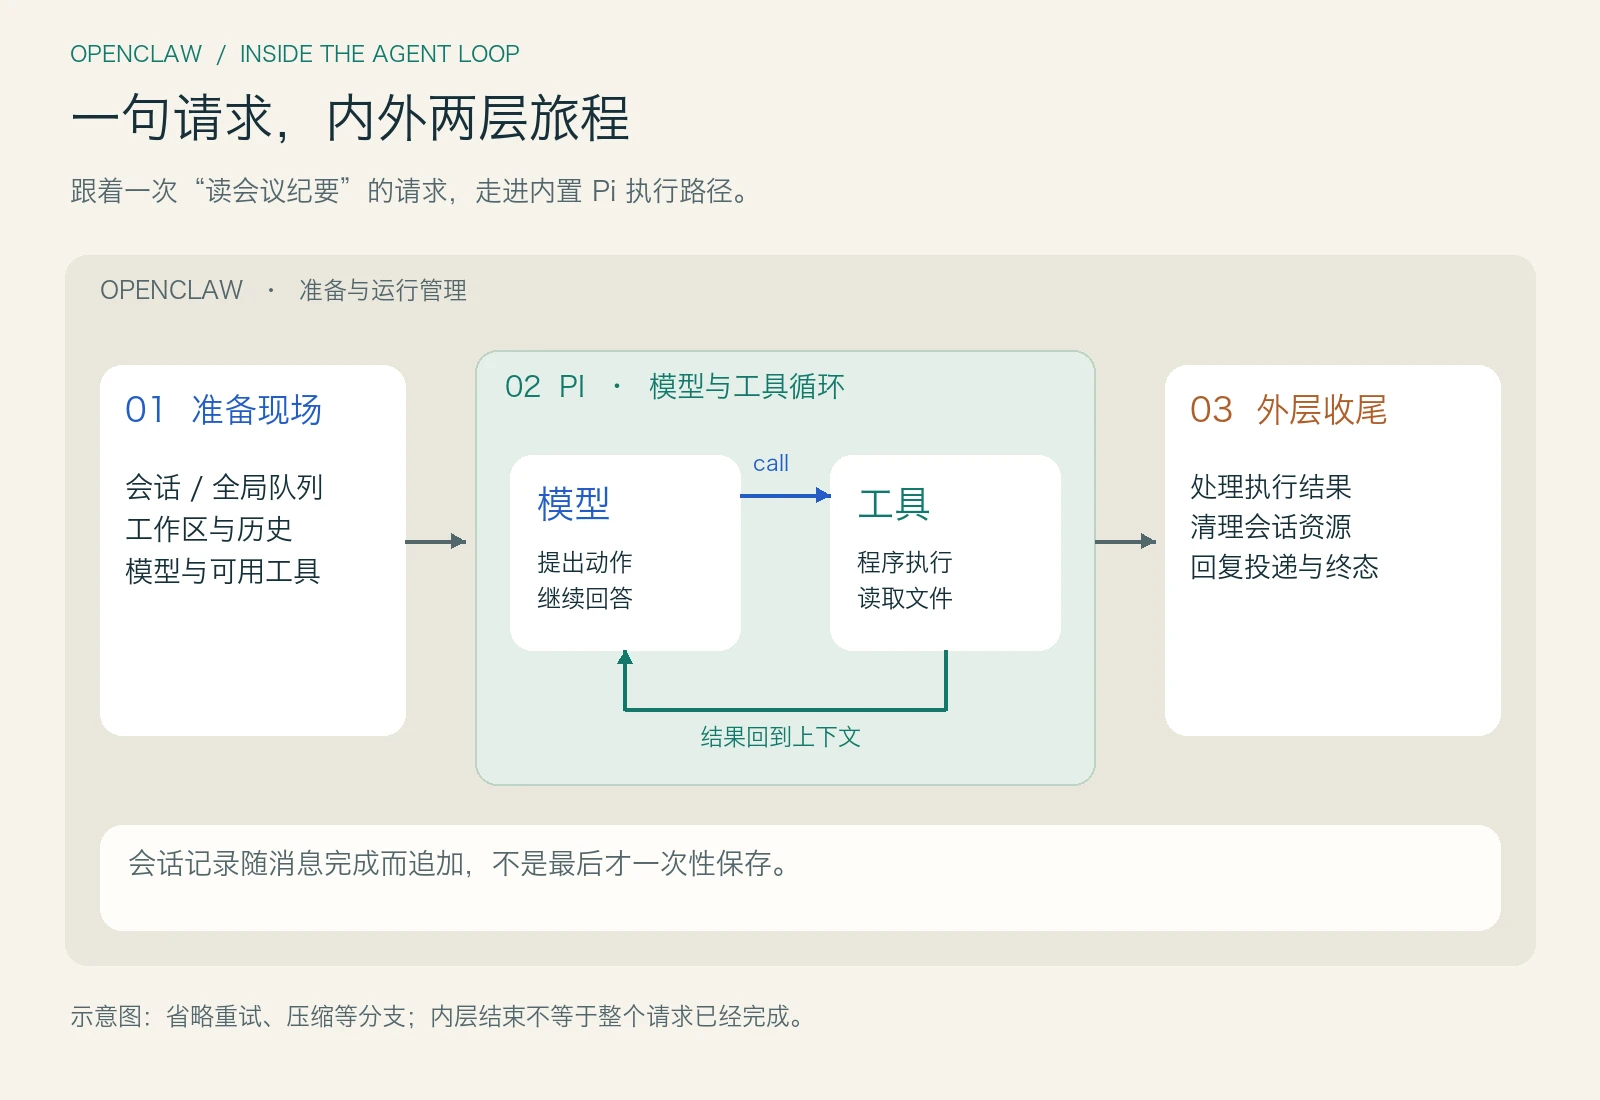
所以,OpenClaw 在模型调用之前先做了一层组织工作。在我们追踪的路径上,请求进入会话队列,再受全局执行队列约束;接下来准备模型、工作区、会话记录和工具。这里的“排队”不是说整台机器永远只能干一件事,而是不同层级有不同的并发边界。队列入口
对会议纪要这个例子来说,这一步的意义很具体:同一个会话里的另一项任务,不应该随意插进来,把本轮正在使用的上下文搅乱;模型拿到的也不能只有一句孤零零的“帮我读一下”,还需要知道自己能用哪些能力。
走到这里,OpenClaw 才把准备好的运行交给所选 harness。内置 Pi harness 会进入 OpenClaw 的单次执行准备逻辑,创建 Pi 的 AgentSession,装入模型和工具,再提交用户提示。OpenClaw 负责把工作现场准备好,Pi 的核心循环负责推进模型与工具之间的来回。 两层之间还有会话管理、事件订阅等连接工作,并不是一次简单的函数转发。会话创建与提交
第一次回答,其实是在提出一个动作
现在模型看到了你的要求。假设它决定先读取文件,并输出了一句“我先看看会议纪要”。
紧跟这句话的,可能不是更多正文,而是一段结构化的工具调用:工具名是 read,参数里有文件路径,还有一个用来关联结果的调用 ID。为了看清关系,可以把它简化成这样,具体参数以实际注册的工具为准:
assistant
  text: 我先看看会议纪要。
  toolCall: read(path="notes/meeting.md"), id="read-1"
这时模型已经结束了一次输出,但用户要的三件待办还不存在。它只是把下一步动作交了出来。
真正访问文件的是宿主程序注册的工具函数。Pi 会查找工具、验证参数,并经过执行前钩子,再调用工具的 execute。工具返回后,循环把输出包装成 toolResult,用 toolCallId 对应到刚才的动作。工具执行入口
这个分工值得停下来想一想。如果模型输出一句“读取成功”就能算文件真的读过,系统便无法区分事实与语言。结构化调用把两者分开:模型提出要做什么,程序负责执行,并留下实际结果。工具名和参数也因此成为可检查的边界,而不是一段需要猜测的自然语言。
当然,这并不意味着有了 execute 就自动具备完整的安全保障。OpenClaw 如何筛选工具、怎样施加权限与沙箱约束,是更外层的责任。此处先记住:模型能表达一个动作,不等于它自己已经做完了这个动作。
文件读完了,故事才走到一半
读取工具拿回会议纪要。假设其中有三项待办:确认需求范围、完成回归检查、发送发布说明。
你也许会觉得,既然答案就在文件里,把工具输出直接显示出来不就好了?但你的要求是“把需要我做的三件事列出来”。真实纪要里还可能有讨论过程、其他人的任务和已经取消的安排。文件内容是证据,还需要有人按你的问题组织答案。
Pi 的做法是把工具结果放回本轮上下文,继续调用模型。第二次模型看到的,已经不只是原来的问题,而是“用户请求、自己提出的读取动作、工具返回的内容”这一段完整经过。工具结果没有冒充用户的新消息,它有自己的角色与关联 ID。循环实现
于是,这个简单场景的一次请求,展开成了四条关键记录:
user        → 读会议纪要,列出我的三个待办
assistant   → 我先看看 + read 工具调用
toolResult  → 会议纪要的实际内容
assistant   → 整理后的三个待办
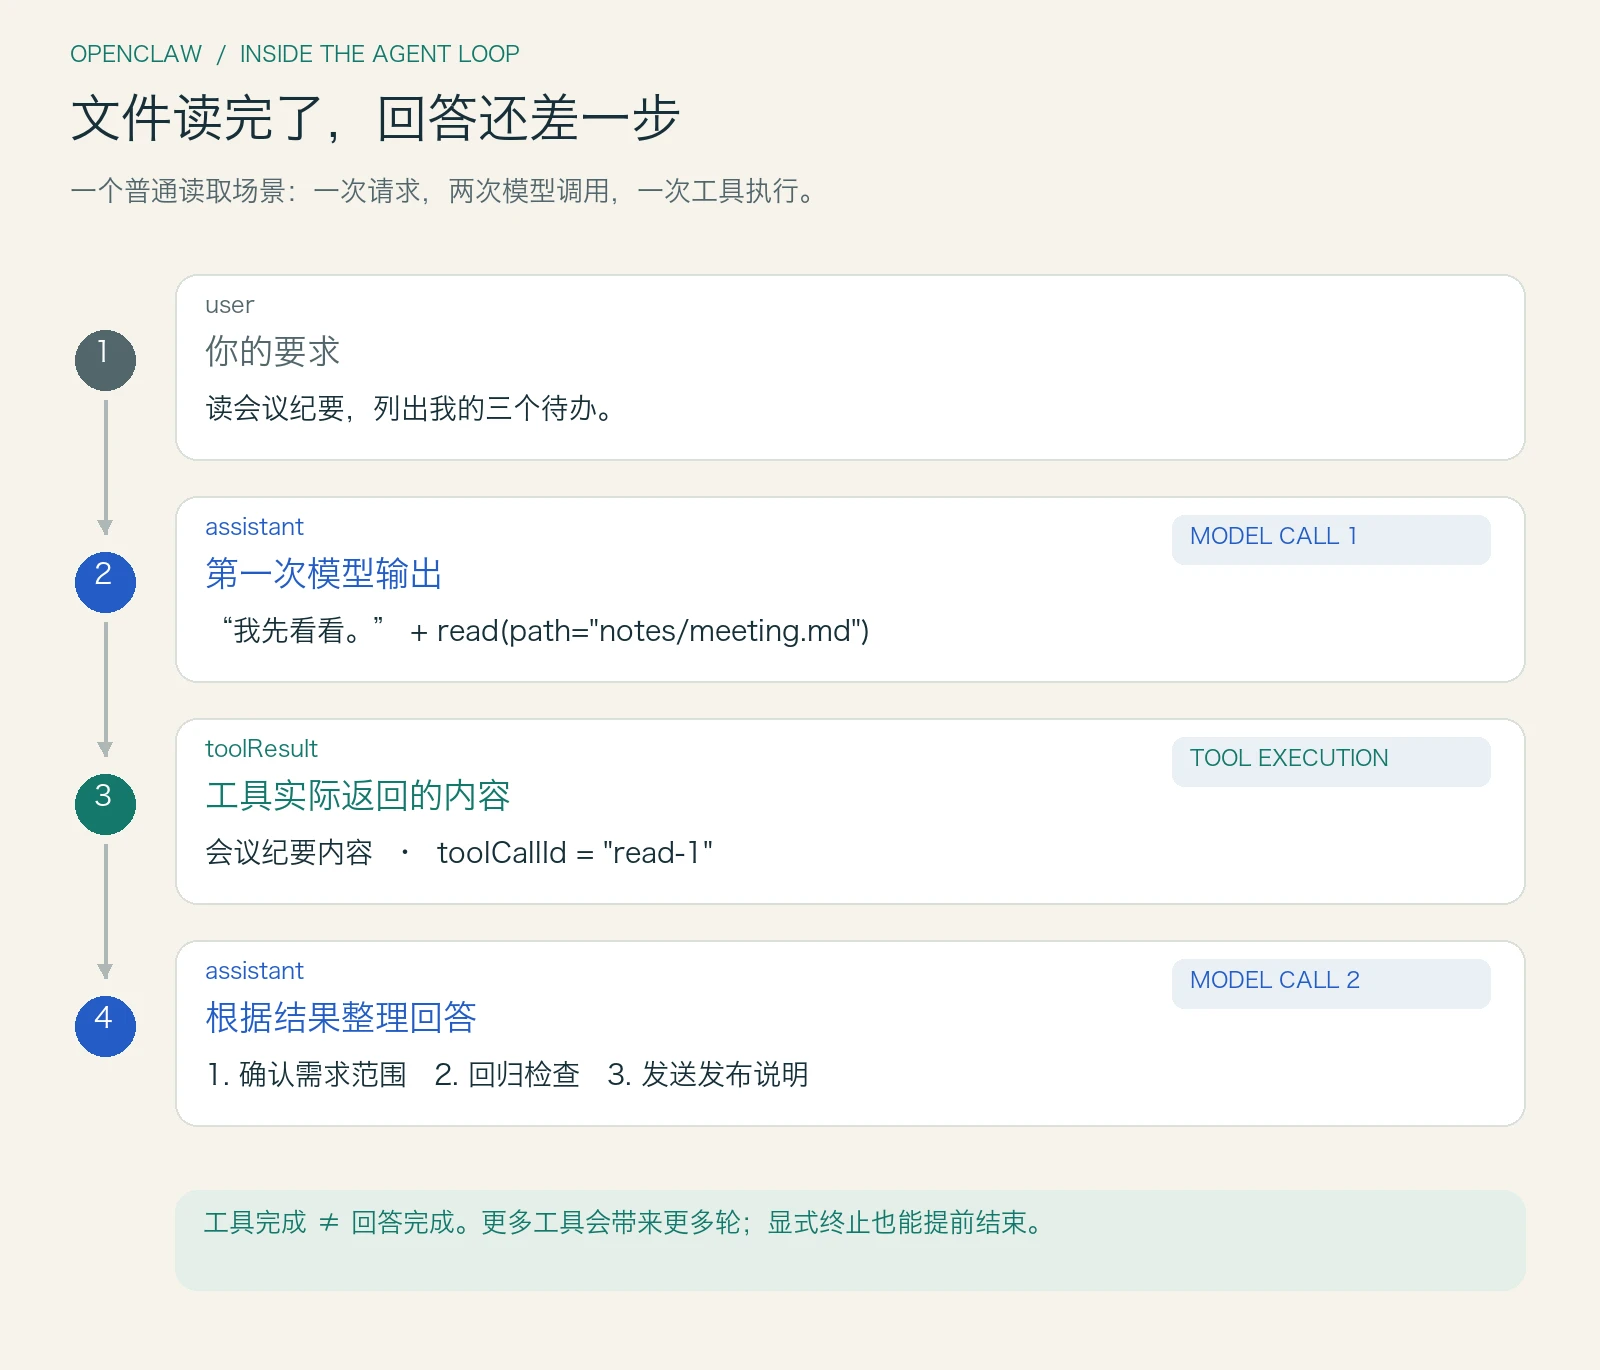
图中的两次模型调用属于这个具体场景。如果需要继续读取其他文件,循环还会往下走。
这也是为什么不能用“模型调用次数”来直接替代“用户请求数”。一条请求里可以包含多轮模型输出和工具执行。第一次模型负责决定去哪里找信息,下一次再根据拿回来的信息继续工作。Agent 的连贯感,就来自程序把这些步骤接成了同一段过程。
实现里还保留了转向消息和后续消息的入口。当前一轮没有新的工具调用,也不一定马上离开循环;如果存在需要继续处理的消息,它仍然可以推进。反过来,显式停止钩子或带终止语义的工具结果,也可以让循环提前结束。因此,“读完一定再问一次”不是普遍定律,而是我们这条普通读取路径的行为。
如果它只说“我先看看”,然后就安静了
现在给故事加一点意外:读取动作完成了,后续输出却没有正常回来。聊天窗口里还留着“我先看看会议纪要”。
对人来说,这显然不像交付完成。但对程序来说,如果判断条件只是“有没有输出过文字”,这次运行很容易被误判为成功。工具之前的礼貌回应,也会被算作一份有效答案。
OpenClaw 的历史修复里恰好出现过这个问题。PR #76544处理的就是“工具前已经有文字,工具后的最终回答却缺失”的情形:不能因为已经产生文本,就绕过未完成回合的检测。我们阅读的版本中,相关判断会关注最后一条助手消息是否仍停在 toolUse,不再让先前的可见文字把这一信号盖过去。未完成回合检测
这件事很有启发:聊天界面的“看起来有回应”和运行时的“任务走到了合法终点”,是两种不同的信息。进度说明当然有价值,但它不应该替代终态。
也不要把规则反过来理解成“所有工具执行之后都必须再写一段自然语言”。有的工具本身已经把消息送到了目标渠道,有的路径明确要求终止。正确做法是结合执行协议和具体结果判断完成,而不是要求所有任务都长成同一种对话形状。
出错时,先把事实交回来
再换一种意外:文件不存在,或者读取工具抛出了错误。
在 Pi 的这条执行路径里,工具执行异常会被转成带 isError 的工具结果,交回后续上下文。模型因而有机会告诉你“没有找到这份文件”,或者在可用能力允许时调整下一步,而不是让整个对话只剩下一条程序异常。
这和模型本身以 error 或 aborted 停止不同:后一种情况会结束当前核心循环。至于外层是否重试、切换模型或给出错误回复,要继续看 OpenClaw 的运行控制,不能从内层循环直接推断。错误与停止分支
把失败也当作结构化结果,是这里第二个值得学的设计。它让“发生了什么”和“接下来怎么做”保持衔接。不过,恢复能力并不意味着可以无条件重复操作。读文件通常容易重来,发消息、创建任务、扣款就完全不同;一个执行器必须知道,重试可能把现实世界的动作做两遍。
清单写好了,还有一小段路
终于,模型给出了三个待办,当前循环没有更多工作,Pi 发出了 agent_end。如果只盯着这个名字,很容易觉得所有事情都已经结束。
但在这条 OpenClaw 路径里,内层循环结束和外层运行终态仍然分开。外层要处理结果,以及适用情况下的回复投递等后续工作;源码还明确把终态延迟到外层处理。外层结束边界
与此同时,会话记录也不是最后才一次性保存。消息完成时,会话层就会处理记录追加。会话事件处理退出单次执行时,还有待处理工具结果、事件订阅和会话资源需要清理。
这里藏着一个很具体的工程教训:不要太早“修复”缺失的工具结果。执行代码的注释提到,如果重试中的工具尚未真正结束,清理逻辑就去补齐记录,可能插入人工合成的缺失结果错误。于是正常清理会先尽力等待 Agent 空闲,再刷新待处理结果。这个等待有时间上限,取消场景还会缩短或跳过部分等待;它不是无限期保证所有后台工作结束。清理入口、有界等待实现
从用户视角,这些事情都躲在一份简单的待办清单后面。但它们决定了下一条消息进来时,系统面对的是一段能继续使用的会话,还是一堆彼此对不上的中间状态。
把这个小故事放进可重复的实验
为了确认前面的来回顺序,我对 OpenClaw 锁定的 Pi 0.75.4 原始发布模块做了一个小实验:用确定性的模型替身,第一次返回读取动作,第二次返回清单;读取工具实际访问本地临时文件。实验里的文件名简化为 meeting.md,三项内容事先写入,最终清单也由替身预设。
观察结果是:一次请求、两次模型调用、一次文件读取;第二次调用确实收到了文件内容,记录顺序是 user → assistant → toolResult → assistant。连同工具失败、停止钩子和 OpenClaw 清理等待等分支,共有 27 项局部检查通过。
这验证的是循环如何推进,不是模型能否理解会议纪要。参数校验在实验中使用了替身,也没有启动完整 OpenClaw、连接真实模型或复现线上渠道。因此,不能把这份结果当成权限验证、模型效果或端到端可靠性的证明。
如果让我从零写这个小助手,我会先保留三个清晰的接口:模型输出动作,工具返回带关联 ID 的结果,循环决定继续还是结束。然后再逐步补上会话、并发和恢复机制。OpenClaw 展示了这些能力接入真实产品后的复杂度;阅读时沿责任边界拆开,比把所有逻辑塞进一个不断变长的循环更容易理解和替换。
回到最开始那句“帮我读一下”。真正值得留意的,不只是模型最后写出了什么,而是它需要信息时,系统能否替它拿到;动作失败时,能否把事实带回来;准备结束时,能否分清进度、结果和收尾。那份看似顺手生成的清单,正是这样一步一步接起来的。
下一篇继续沿着这次 read 往下看:模型面前的工具是怎么挑出来的,又是谁决定它到底能不能执行。