假设那份项目清单已经整理到最后一步。
OpenClaw 读完文件,讨论过修改范围,也把长对话压缩成了交接摘要。你刚说“按这个方案继续”,模型服务却返回了限流错误。过了一会儿,助手又开始工作,界面还提示换用了备用模型。
看起来像一个简单的补救:A 不行,就找 B。
但如果 A 只是当前账号额度用完,为什么要立刻换模型?如果失败的是本地会话文件锁,换 B 又有什么用?更麻烦的是,你可能在等待期间手动选了 C,恢复逻辑还能不能把会话悄悄改回去?
这一篇从这些问题出发,拆解 OpenClaw 如何判断失败、安排下一次尝试,以及保存切换后的状态。故事里的清单任务是假设场景;源码固定在 v2026.5.22 对应提交,局部实验使用构造数据,没有调用真实模型服务。
先换一把钥匙,还是换一扇门
“模型不可用”经常是过于粗糙的描述。同一个提供方可以配置多个凭据档案,也就是 auth profile。它们可能来自不同账号或认证方式,面对的额度和可用状态也不同。
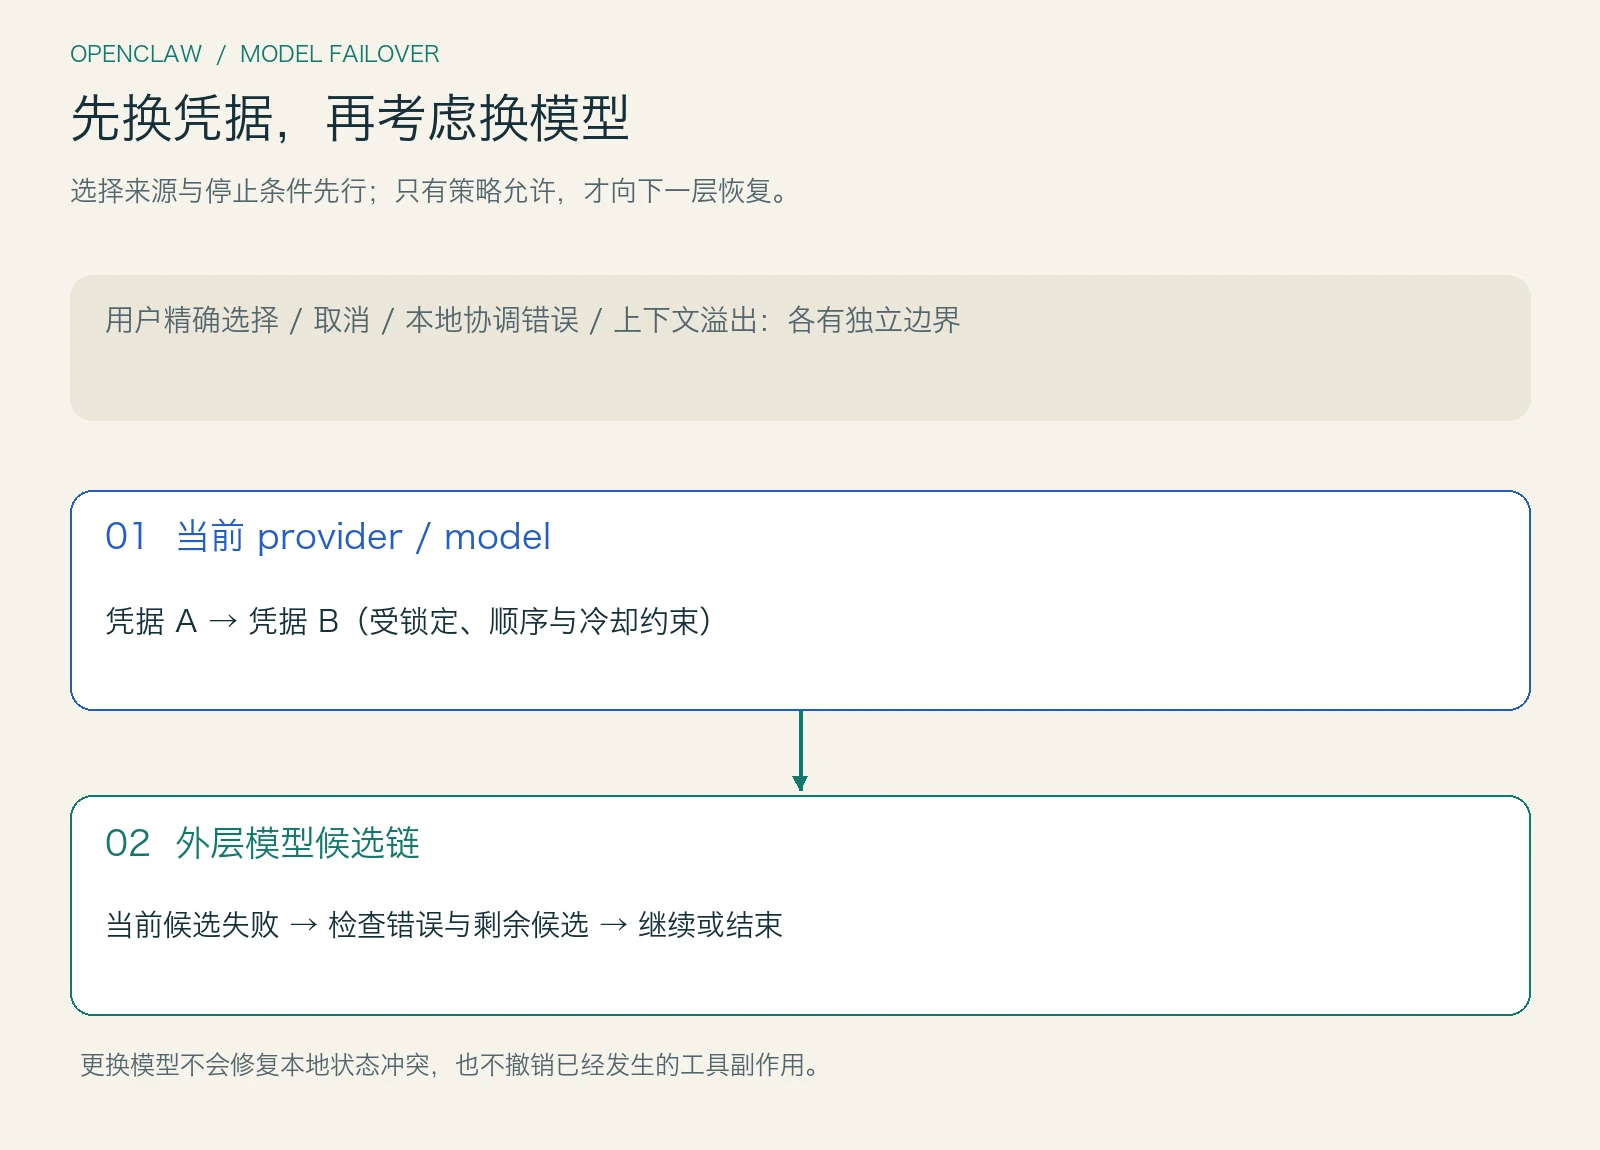
OpenClaw 把恢复分成两层:当前提供方内部的 profile 轮换,以及外层的模型候选链。前者仍然尝试当前模型,后者才可能改变 provider/model。这样的分层,让“这张通行证暂时不能用”不必立即升级成“整个服务都不能用”。凭据排序 · 内层运行器
排序也不等于每次都随机换账号。配置顺序、会话偏好和冷却状态共同参与决策。自动选中的 profile 可以作为优先尝试的偏好;用户锁定的 profile 则有更严格的约束。讨论轮换时,必须保留选择来源这个条件,否则很容易把“自动帮我挑一个”误写成“可以覆盖我的明确选择”。
模型层也有同样的区分。默认模型可以配 fallback;用户在会话中明确选择的模型属于精确选择,不应失败后偷偷改由无关的默认候选回答。自动故障切换则会带上 auto 来源信息,供后续运行继续识别。具体入口还有 agent、cron、单轮覆盖等差别,本文聚焦普通会话的主线。选择来源约定
对架构设计来说,值得保留的不是某个字段名,而是“选中了什么”和“为什么选中”必须一起传递。只有一个 model 字符串,下游无法判断它是默认值、系统补救,还是用户不可替换的要求。
同样一个错误码,未必是同一种故障
接下来,运行器需要把外部服务各式各样的失败翻译成内部可以执行的决策。
FailoverError 不只装着一段报错文字,还记录 reason、provider、model、profileId,以及可用的状态码和错误码。普通错误会经过归一化;代码会沿着包装对象的 error、cause 查找线索,而不是只看最外层那句“请求失败”。错误结构与归一化
分类器综合 HTTP 状态、结构化 code 和消息内容。这里没有一张“状态码对应动作”的万能表。例如 400、422 不一定只是请求格式错误,响应正文可能明确说明限流、认证或余额问题;如果只有一个没有正文的 HTTP 包装,代码又不会贸然认定成 format。空信息与确定的格式问题被分开处理。信号分类入口 · HTTP 分支
认证失败也有程度区别。invalid api key 这样的含糊信息,与明确说密钥已撤销,不应自动获得同样长的不可用判定。我们直接运行原始匹配模块验证了这一点:前者可以匹配认证错误,却不属于高置信度的永久撤销模式。认证、额度与超时匹配
另一种容易误判的情况是取消。底层库可能用 AbortError 表示用户停止,也可能用它包住超时或结构化限流。候选执行包装会先尝试归一化;有明确限流等线索的包装错误,不会仅因为名字里带 Abort 就全部当作用户取消。候选执行包装
这种设计的代价是规则越来越多,顺序也变得重要。同一条消息可能同时出现“internal error”和“insufficient balance”,先匹配哪一类会改变后续路径。分类器应当被当作有行为契约的模块,持续积累冲突样例,而不是散落在各层的一堆字符串判断。
有些失败,换十个模型也解决不了
回到清单任务。如果错误原因是会话文件被另一个执行过程接管,模型 B 也要面对同一份本地状态。继续遍历候选只会多花时间,并把最终错误伪装成“所有模型都失败了”。
这个版本的外层 fallback 会识别不带提供方失败依据的本地协调错误,例如会话写锁超时和 embedded attempt takeover,并直接向上抛出。它还把逃逸到外层的上下文溢出交还给内层压缩与恢复路径,不把换一个可能窗口更小的模型当作通用解决方案。外层停止条件
这与上一篇的上下文压缩恰好接上:上下文太大,先处理输入;提供方暂时不可用,才讨论换路。错误发生在哪一层,应当影响修复发生在哪一层。
不过,也不能反过来写成“只有已识别的错误才会尝试备用模型”。实际外层循环对部分未识别错误仍允许继续,只要还有候选。明确停止的分支先被排除,剩下的未知错误可以留下失败记录并向后尝试;最后一个候选仍是未识别错误时,会抛出该错误。已归类的候选失败耗尽后,则可形成带各次原因的 FallbackSummaryError。未知错误与耗尽处理
因此,真正的策略并不是“遇错重试”,也不是“未知必停”。它是一个有顺序的决策过程:先保护取消和本地状态边界,再判断是否还有能够尝试的候选,并保留每一步为什么失败。
备用模型不是无限次重来的许可证
候选链本身先规范化模型引用,再收集候选、按 provider/model 去重。显式提供的 fallback 列表即使为空,也会替换默认列表。空列表表达“不要继续换”,不能被当成没有配置又补回默认值。候选构建
外层候选数还不是所有重试的总数。一个候选内部可能轮换凭据,也可能走压缩恢复等分支。OpenClaw 因此给内层运行循环设置了额外防御上限,默认计算可以概括成:
limit = min(160, max(32, 24 + max(1, profileCount) × 8))
这是这个固定版本的默认值,配置可以覆盖。我们验证了一个 profile 得到 32、两个得到 40、很多 profile 被封顶到 160。它限制的是内层循环迭代,不能拿来宣称“模型一定会重试 32 次”,更不是完整请求的费用预算或严格总时长承诺。运行循环上限
已经失败的 profile 还需要暂时让路。普通冷却函数按错误计数返回 30 秒、1 分钟、5 分钟,之后封顶;余额和高置信度永久认证失败另走较长的 disabled 策略。这里不能套用网上常见的某条指数退避公式来解释所有错误。冷却与不可用策略
一个小细节很有价值:如果冷却窗口仍然有效,普通更新路径保留原到期时刻,不因窗口内再遇到失败就不断把截止时间往后推。等窗口过期,再按规则重新计算。否则一个频繁被探测的坏凭据,可能永远没有机会结束冷却。有效窗口处理
冷却在这里是调度状态,不等于把用户请求睡眠五分钟。外层会结合可用 profile 与受限探测决定跳过还是尝试。凭据冷却、模型候选、内层循环分别限制不同资源,想知道一次任务到底等了多久,仍需要把它们放进完整执行轨迹里看。
B 接手了,会话应该记住谁
假设 A 确实限流,B 可以继续处理清单。切换不只是把下一次请求的 model 参数换掉,还涉及会话里记录的“当前正在使用谁”。
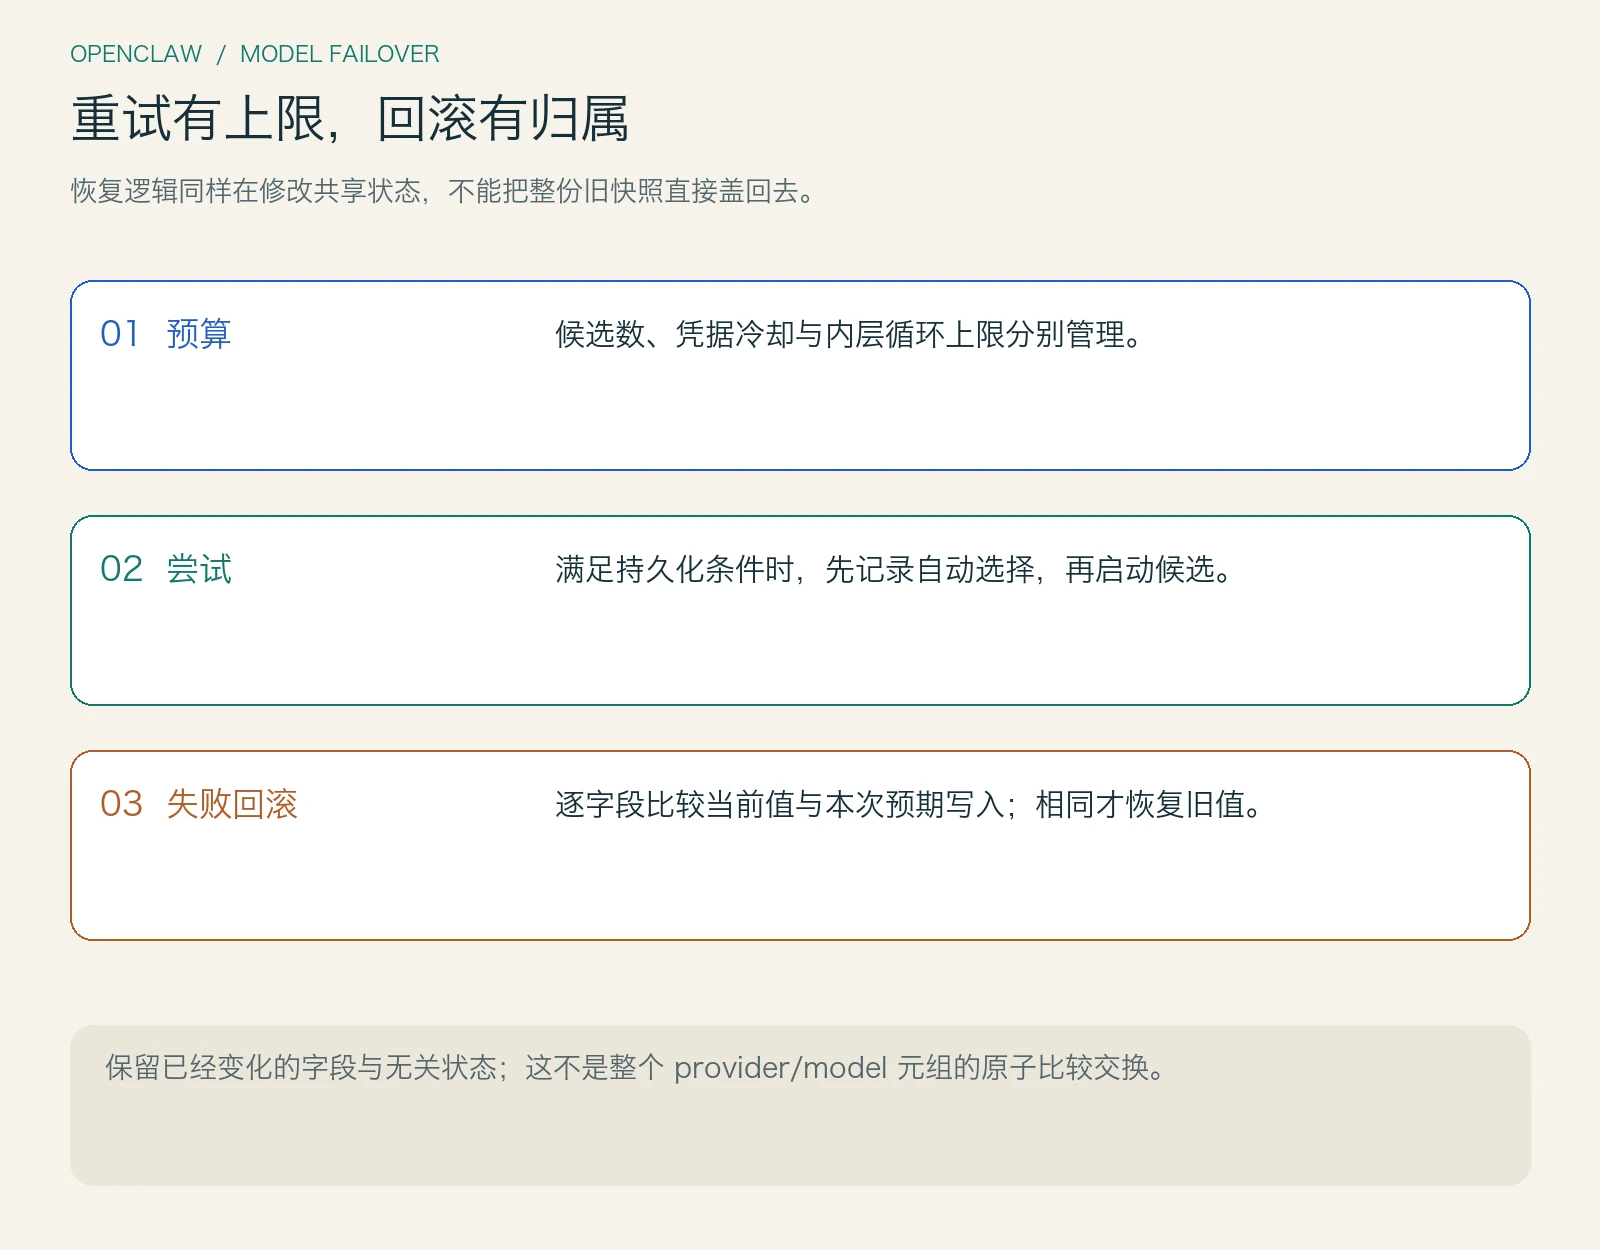
普通持久化会话的执行包装,在满足条件时会先写入 fallback 选择,再启动相应候选。字段包括 provider/model、自动来源和原始模型信息。这样其他会话读取者不至于看到“仍在用 A”,而执行器已经在请求 B。用户来源覆盖、单轮覆盖等情况有专门守卫,不属于无条件落盘。切换选择的持久化
如果 B 也失败呢?最危险的做法是取出尝试前的整个会话快照,整份覆盖回去。等待期间新追加的状态、会话轮换或用户刚选的模型,都可能被一起抹掉。
OpenClaw 的回滚函数只遍历自己负责的选择字段,并逐一比较:当前值仍等于这次 fallback 写入的预期值,才恢复旧值;已经变化的字段保留。按字段回滚
我们的构造实验把模型字段改成用户新选的值,同时改变一个无关的 sessionId,再执行回滚:这些新值保留下来了。但这里有一个必须说明的边界:比较是逐字段的,未变化的 provider 字段仍可能恢复旧值。它不是将整个 provider/model 元组作为一笔原子比较交换。本地测试验证了函数实际做什么,没有证明所有并发交错下的完整会话一致性。
这样的细节,比“支持自动 fallback”更能说明工程成熟度。恢复逻辑也在修改共享状态,因此它同样需要知道哪些数据归自己负责,哪些变化属于后来发生的事。
如果要把这套设计带走
我会先分清三个接口:分类器返回失败原因与证据,策略层决定停止、轮换还是换模型,状态层负责记录和有条件回滚。模型调用作为独立执行器,既不偷偷增加候选,也不把本地锁错误包装成服务商故障。
验证也应该分层:用冲突错误样例测分类,用确定的时钟测冷却,用少量候选测停止条件,再用并发场景测状态所有权。本篇完成的 30 项局部检查覆盖错误文本匹配、冷却窗口、循环上限和内存字段回滚;完整结构化分类、真实提供方故障、模型链和持久化并发仍只做了源码分析。
最后还要留意,恢复模型请求并不等于回滚外部动作。如果之前某个工具已经产生副作用,切换模型不会替它提供幂等性。清单保存是否完成,应由工具结果和文件状态回答,而不是由“备用模型成功了”代替判断。
用户最终看到的也许只有一句“已切换到备用模型”。背后真正值得学习的,是让每次重来都有理由、有边界,并且不要因为急着把活继续下去,弄丢了用户刚刚作出的决定。